Pomiar kosztu zadania: raport narzędzia nie jest fakturą Przez kilka tygodni notowałem koszt zadań z pola, które […]
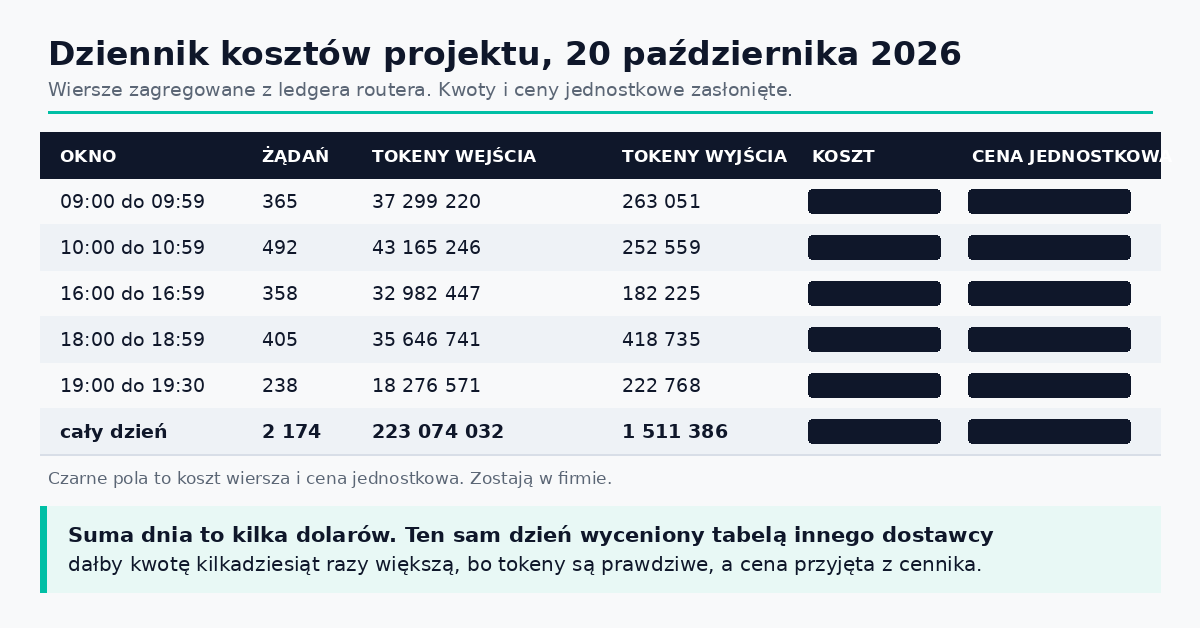
Przez kilka tygodni notowałem koszt zadań z pola, które narzędzie pokazywało na końcu pracy. Liczby były spójne, więc im wierzyłem. Potem porównałem jeden dzień z ledgerem routera i okazało się, że raport zawyżał koszt kilkadziesiąt razy. Nie przez tokeny, bo te były prawdziwe. Przez cenę, przyjętą z cennika dostawcy, do którego żadne z tych zapytań nie trafiło.
Pomiar kosztu zadania zaczyna się więc od niewygodnego pytania: skąd wiem, że ta liczba jest rachunkiem, a nie kosztorysem. W tym wpisie pokażę:
- skąd bierze się zawyżenie rzędu pięćdziesięciu razy i dlaczego błąd idzie w obie strony,
- metodę delta, czyli odczyt licznika przed zadaniem i po nim,
- metodę ledgera, czyli wpis na każde żądanie po stronie routera,
- jak prowadzić dziennik kosztów projektu, żeby nie zamienił się w arkusz na dwieście wierszy,
- jak porównywać zadania między modelami i co z tym zrobić w małym biurze.
To czwarta i ostatnia część serii o pracy z wieloma modelami. Router daje jedno miejsce, routing decyduje, kto pracuje, a pomiar mówi, ile to kosztowało.
Dlaczego liczby w raportach kłamią
Pole z kosztem w wyniku narzędzia nie jest zapytaniem do dostawcy. To mnożenie, które narzędzie wykonuje samo: bierze tokeny z odpowiedzi i podstawia je pod własną tabelę cen. Na modelach Anthropica tabela się zgadza. Kiedy kierujesz to samo narzędzie przez router do innego dostawcy, tabela zostaje, a zapytania idą gdzie indziej.
U mnie wyglądało to tak: Claude Code przez ccrx, czyli przez OpenRouter, z modelem DeepSeek na końcu. Tokeny w raporcie były prawdziwe, bo pochodziły z odpowiedzi. Cena pochodziła z tabeli Anthropica, bo narzędzie nie ma pojęcia, kto naprawdę wystawi rachunek. Konfigurację opisałem we wpisie Claude za półdarmo, jak używać Claude Code przez OpenRouter z DeepSeek.
Policzmy jedno zadanie: dwieście tysięcy tokenów wejścia i trzydzieści tysięcy wyjścia. Tabela Anthropica, trzy i piętnaście dolarów za milion, daje w tym zadaniu jednego dolara i pięć centów. Cennik modelu, który faktycznie odpowiedział, dziewięć i osiemnaście centów za milion, daje dwa i trzy dziesiąte centa. Ten sam przebieg, dwie liczby, stosunek czterdzieści pięć do jednego.
Wynik zależy od proporcji wejścia do wyjścia, bo ceny nie różnią się w tym samym stopniu. Wejście jest tańsze trzydzieści trzy razy, wyjście osiemdziesiąt trzy. Zadanie, które dużo czyta i mało pisze, wychodzi w raporcie czterdzieści jeden razy droższe. Zadanie piszące dużo, na przykład generowanie kodu, sięga siedemdziesięciu ośmiu razy. Stąd „około pięćdziesiąt razy”. To nie stała, to przedział.
| Liczba, którą widzisz | Czym jest naprawdę |
|---|---|
| koszt w wyniku narzędzia | tokeny pomnożone przez tabelę cen dostawcy, którego narzędzie zna, a nie tego, który wystawi rachunek |
| zużycie tygodniowe z API klucza | suma tylko tych żądań, które przeszły przez ten klucz, bez ruchu idącego inną drogą |
| tokeny pomnożone przez cennik z sieci | kosztorys bez wiedzy o pamięci podręcznej i tokenach rozumowania |
| kwota z ledgera routera | tyle zostało naliczone za żądanie w chwili jego obsługi |
Błąd nie idzie tylko w górę i to jest część, którą łatwo przeoczyć. Licznik klucza pokazuje wyłącznie ruch przez ten klucz. U mnie większość zapytań szła bezpośrednio do dostawcy modelu, więc suma z API klucza była o dwa rzędy wielkości niższa od rzeczywistego wydatku. Wyglądała wiarygodnie, bo była precyzyjna. Precyzja nie jest tym samym co poprawność.
Trzeci wariant tego samego błędu jest najczęstszy w arkuszach: wziąć tokeny z logu i pomnożyć przez cennik z sieci. To ten sam błąd z innym autorem, bo pomija pamięć podręczną i tokeny rozumowania, liczone inaczej niż zwykłe wyjście.
Raport nie kłamie złośliwie. Odpowiada rzetelnie na pytanie, ile to zadanie kosztowałoby u dostawcy, którego cennik zna. To nie jest pytanie, które zadajesz, patrząc na rachunek.
Metoda delta: licznik przed i po
Pierwsza metoda jest stara jak licznik wody. Odczytujesz stan przed zadaniem, odczytujesz po, odejmujesz. Potrzebujesz jednego licznika, który rośnie razem z wydatkiem. W OpenRouter jest to zużycie na poziomie klucza, sumowane od początku jego życia.
- Zapisz stan licznika przed wysłaniem zadania, razem z godziną i strefą czasową.
- Uruchom zadanie i doprowadź je do końca, także wtedy, gdy skończy się błędem.
- Zapisz stan licznika po ostatniej odpowiedzi, w tej samej strefie czasowej.
- Odejmij. Różnica to koszt zadania, razem z próbami, które nie doszły do skutku.
- Wpisz różnicę do dziennika z modelem, który odpowiedział, i liczbą tur.
Przykład rachunku, nie moja faktura. Stan przed zadaniem cztery dolary dwadzieścia, po zadaniu cztery trzydzieści osiem, więc koszt to osiemnaście centów. Przy zadaniu na godzinę i trzydzieści tur ta liczba zawiera też dwie nieudane próby i przejście na zapas.
Metoda ma trzy warunki i wszystkie muszą być spełnione, inaczej wynik jest sumą dwóch zadań i nikt tego nie zauważy.
- Ten sam klucz. Licznik należy do klucza, nie do zadania. Jeśli zadanie poszło dwoma kluczami, mierzysz jednym i nie wiesz o drugim.
- Nic innego nie pracuje. Cron o pełnej godzinie albo druga sesja agenta dokładają swoje zużycie do różnicy.
- Ta sama strefa czasowa. Znaczniki z API są w UTC, a dziennik prowadzisz lokalnie. Dwie godziny różnicy wystarczą, żeby okno objęło cudzy ruch.
Jest też ograniczenie rozdzielczości. Zadanie za ułamek centa da różnicę zero albo przeskok o jeden krok zaokrąglenia. Delta sprawdza się od kilku centów w górę, przy jednym długim zadaniu i pewności, że nic nie chodzi w tle. Niżej mierzysz zadanie razem z sąsiednimi albo przechodzisz na ledger.
Metoda ledgera: wpis na każde żądanie
Druga metoda nie mierzy różnicy, tylko czyta zapis. Router zapisuje po każdym żądaniu wiersz: który klucz, dostawca, model, ile tokenów wejścia i wyjścia, ile z pamięci podręcznej, jaka cena jednostkowa, jaka kwota naliczona i kiedy. W OmniRoute ta tabela nazywa się ledgerem kosztów żądań.
Zalety wynikają z tego, że nie ma tu odejmowania. Nie ma zaokrągleń, bo nie ma różnicy dwóch zaokrąglonych liczb. Praca równoległa nie psuje wyniku, bo każde żądanie ma własny wiersz. Widać model, który odpowiedział po przejściu na zapas. Delta mówi „ile”, ledger mówi też „na co”.
Odczyt jest krótki. Bierzesz granice zadania z przebiegu pracy i sumujesz kwoty z tego okna, grupując po modelu.
SELECT model,
       COUNT(*)           AS zadania,
       SUM(amount_usd)    AS koszt,
       SUM(tokens_input)  AS wejscie,
       SUM(tokens_output) AS wyjscie
FROM request_cost_ledger
WHERE timestamp >= '2026-10-20T09:00:00'
  AND timestamp <= '2026-10-20T09:59:59'
GROUP BY model;
Jedna rzecz jest tu ważniejsza od pozostałych: suma bierze kolumnę z kwotą, a nie iloczyn tokenów i ceny jednostkowej. Kuszące jest przeliczenie samemu, bo cena leży w tym samym wierszu, ale to powtórka błędu z pierwszej sekcji w miniaturze. Pamięć podręczna i tokeny rozumowania mają inne stawki, a kolumna z kwotą jest już po naliczeniu. Kwota to fakt, cena jednostkowa to założenie.
Drugi warunek dobrego odczytu to etykieta zadania. Bez niej ledger powie, ile kosztowało okno, a nie ile kosztowało zadanie. Najprościej: osobny klucz dla jednego rodzaju pracy, dalej nagłówek z identyfikatorem zadania albo wrapper dopisujący linię z jego nazwą.
Trzeci warunek bywa pomijany: nieudane żądania też kosztują. Żądanie, które zwróciło błąd po dwudziestu sekundach generowania, ma swój wiersz i swoją kwotę. Zadanie, które po trzech próbach nie dało wyniku, kosztuje i nie produkuje niczego. Wyfiltrowanie błędów daje ładniejszą liczbę i gorszą decyzję.
W praktyce te metody się uzupełniają. U mnie ruch w chmurze szedł przez klucz, a większość zapytań bezpośrednio do dostawcy modelu, więc licznik pokazywał wycinek, a ledger bramki całość. Dlatego źródło prawdy wybierz raz i zapisz w dzienniku, skąd pochodzi każda kwota.
Dziennik kosztów projektu
Ledger mówi, ile wyszło z konta. Dziennik mówi, czy było warto. Dziennik kosztów projektu nie jest raportem finansowym. Jest notatką, która po miesiącu pozwala odpowiedzieć na jedno pytanie: który rodzaj zadania zjada budżet i nie zwraca tego w czasie.
Siedem kolumn, jeden wiersz na zadanie. Wpis zajmuje dwadzieścia sekund, jeśli koszt jest już policzony z ledgera.
- data i godzina rozpoczęcia,
- zadanie w trzech słowach, na przykład „tabela z katalogu”,
- poziom z routingu: proste, średnie albo trudne,
- model, który faktycznie odpowiedział, bo po przejściu na zapas to często nie ten zamówiony,
- koszt z ledgera, razem z nieudanymi próbami,
- minuty poprawek i weryfikacji,
- czy wynik przeszedł za pierwszym razem.
Ostatnia kolumna jest najważniejsza i najczęściej pomijana. Koszt bez informacji o poprawkach prowadzi do wniosku, że tani model zawsze wygrywa, a to nieprawda. Pięć minut czytania wyniku, który znasz na pamięć, jest tańsze niż cent oszczędzony na modelu. Piętnaście minut szukania przesuniętego wiersza w tabeli, która poszła do klienta, jest droższe niż miesiąc pracy mocniejszego modelu na tym jednym typie zadania.
Przegląd raz w miesiącu, piętnaście minut. Trzy pytania: który typ zadania ma najwyższy koszt na przyjęty wynik, jaka część wierszy wymagała poprawek i jak często model odpowiedział inny niż zamówiony.
Dziennik prowadzę w pliku, nie w bazie. Arkusz z wykresami wygląda lepiej na spotkaniu, ale wymaga wprowadzania danych, a to wymaga nawyku. Siedem kolumn w pliku otwiera się w arkuszu, gdy trzeba. Granice zadań biorę z przebiegu pracy, więc nie przepisuję ich ręcznie. Jeśli prowadzisz zadania w systemie z zapisanym czasem startu i zakończenia, połowa roboty jest zrobiona. Pisałem o tym we wpisie Hermes Agent, czy warto?
Jak porównywać zadania między modelami
Najczęstszy błąd w porównaniach to cena za milion tokenów. Wygląda jak jedyna wspólna miara, a jest miarą czegoś innego niż koszt zadania. Dwa modele w tej samej cenie za token mogą różnić się kosztem zadania trzykrotnie, z dwóch powodów: jeden pisze więcej, a drugi częściej się myli.
Pierwszy powód jest mechaniczny. Model rozwlekły potrafi wygenerować dwa i pół raza więcej tekstu, żeby powiedzieć to samo, a przy stawce za wyjście wyższej niż za wejście różnica w cenniku zaciera się w rachunku. Drugi jest droższy i rzadko wchodzi do porównań: poprawki. Właściwa miara to koszt przyjętego wyniku, czyli suma kosztów wszystkich prób podzielona przez liczbę wyników, które przeszły bez poprawek. W mianowniku nie ma żądań ani tur, są wyniki, których nikt nie musiał ratować.
Przykład z ekstrakcją danych, na prawdziwych stawkach i założonej cenie minuty pracy. Tani model: dwie próby, cztery centy razem, piętnaście minut poprawek. Mocny: jedna próba, czterdzieści centów, pięć minut sprawdzenia. Minuta inżyniera to około półtora złotego, czyli dziewięćdziesiąt złotych za godzinę.
Tani: szesnaście groszy za wywołania plus dwadzieścia dwa złote pięćdziesiąt za poprawki, razem dwadzieścia dwa złote sześćdziesiąt sześć. Mocny: złoty sześćdziesiąt plus siedem złotych pięćdziesiąt, razem dziewięć złotych dziesięć. Mocny wygrywa o trzynaście złotych na jednym zadaniu, choć w cenniku jest dziesięć razy droższy.
To samo zadanie w wersji, w której poprawka jest tania: streszczenie wątku mailowego, które czytasz dwie minuty i widzisz, czy czegoś nie brakuje. Tani: szesnaście groszy plus trzy złote, razem trzy złote szesnaście. Mocny: złoty sześćdziesiąt plus trzy złote, razem cztery złote sześćdziesiąt. Tani wygrywa. Podział nie biegnie więc między modelami, tylko między rodzajami zadań, i to jest jedyny podział wart utrwalenia w regułach routingu.
Trzy zasady, które ratują porównanie przed samooszukiwaniem. Porównuj ten sam typ zadania, nie dwa zadania o podobnej długości. Bierz medianę, nie średnią, bo jedno zadanie w pętli zafałszuje cały tydzień. Zapisuj wersję modelu i datę. I jeszcze jedno: jeśli ten sam model zawodzi na tym samym typie zadania trzeci raz, to zwykle nie model, tylko prompt albo dane wejściowe. Zmiana na mocniejszy maskuje problem i podnosi koszt. Więcej takich powtarzalnych zadań znajdziesz we wpisie AI dla inżyniera, ponad 40 praktycznych zastosowań.
Wnioski dla małego biura
W biurze, w którym pracuje pięć osób, nikt nie będzie prowadził analizy kosztów AI. Rachunek za modele jest mały w porównaniu z roboczogodziną przeznaczoną na jego analizę. Układ ma sens tylko wtedy, gdy sprowadza się do czterech decyzji podjętych raz.
- Źródło prawdy. Kwoty bierzemy z ledgera routera, nigdy z pola w raporcie. Jeśli dwie liczby się różnią, wygrywa ta, która ma wiersz na żądanie.
- Jedna osoba, piętnaście minut. Raz w miesiącu ktoś czyta dziennik i odpowiada na trzy pytania. Nie komitet, nie dashboard.
- Jednostka decyzji. Rozmawiamy o koszcie przyjętego wyniku, nie o cenie za token. Cena za token jest argumentem w rozmowie z dostawcą, nie o własnej pracy.
- Reakcja na wzrost. Gdy koszt rośnie, zmieniamy regułę routingu albo typ zadania, a nie szukamy winnego.
Liczba, którą warto pokazać właścicielowi biura, jest jedna: koszt przyjętego wyniku dla trzech typów zadań, które robisz co tydzień, zestawiony z minutami poprawek. To zamienia wydatek na modele w stawkę godzinową porównywalną z podwykonawcą albo z własnym czasem.
Miara ma jednak koszt własny: uwagę. Dlatego zaczynam od jednego typu zadania, nie od wszystkich. Jeśli po miesiącu dziennik ma dwanaście wierszy, działa. Jeśli ma dwieście, jest zbyt szczegółowy, a dziennik, którego nikt nie wypełnia, jest gorszy od braku dziennika, bo daje pozór kontroli.
Jeśli chcesz sprawdzić to u siebie w trzydzieści minut, weź jedno zadanie z zeszłego tygodnia, znajdź jego okno w ledgerze routera i policz sumę kwot. Potem porównaj z tym, co pokazało narzędzie. Różnica, którą zobaczysz, jest najlepszym argumentem za tym, żeby raportu nie traktować jak faktury.
Sprawdź również:
- Dane nieszablonowe w budownictwie: jak wyciągnąć dane z maili, notatek i PDF-ów
- Jaki komputer do Revita/BIM w 2026: CPU/GPU/RAM/SSD
- Case Study: jak uporządkować wiele skrzynek mailowych w jednym systemie (Thunderbird + AI)
- Chińskie modele AI: co dzieje się z danymi, które do nich wysyłasz
- Jak zwiększyć komfort pracy przy komputerze? Ergonomiczne stanowisko krok po kroku
Treść tego artykułu została stworzona z pomocą sztucznej inteligencji.