Ta sama procedura wklejana do każdego czatu kosztuje tokeny i daje inny wynik za każdym razem. Pokazuję, czym skill różni się od agenta, instrukcji projektu i pamięci, i jak napisać pierwszy skill w 20 minut.
SEO: DO PRZENIESIENIA DO YOAST
Meta description (120-140 znakow): Zapisujesz procedurę raz jako skill z wyzwalaczem i krokami. Porównuję skill, agenta, rozmowę, instrukcje projektu i memory.
Focus keyphrase: skille zamiast wklejania kontekstu
SEO title (50-60 znakow): Skille zamiast wklejania kontekstu do każdego czatu
Te same instrukcje wklejane do każdej rozmowy
Mam w notatkach procedurę kontroli nazw plików przed wgraniem modelu IFC do wspólnego środowiska danych. Osiem pól, myślniki, wielkie litery, poziom zapisany dwiema cyframi. Za każdym razem otwierałem notatkę, kopiowałem blok tekstu i wklejałem go do czatu razem z prośbą.
Po dziesiątym razie zobaczyłem, że nie robię już tego samego. Raz wklejałem całą procedurę, raz skrót, raz tylko listę błędów z ostatniej rozmowy. Wynik też był inny: tabela, akapity, poprawiona nazwa bez wyjaśnienia, czego brakowało.
Problem nie leżał w modelu, tylko w tym, że procedura mieszkała w mojej głowie i w notatce, a nie w miejscu, z którego agent bierze ją sam. Skill to dokładnie to miejsce: plik z wyzwalaczem, krokami i pułapkami, który agent ładuje przy pasującym zadaniu i pomija przy reszcie.
Czym jest skill i czym różni się od agenta, rozmowy, instrukcji projektu i pamięci
Skill to wiedza proceduralna zapisana jako plik. W Hermesie ma nazwę, opis działający jak wyzwalacz i treść z krokami. Opis trafia do listy umiejętności, a pełna treść wchodzi do kontekstu dopiero przy pasującym zadaniu. Ta zasada to progressive disclosure (dostęp 2026-10-25). Poniżej pięć rzeczy, które łatwo pomylić.
| Rzecz | Co to jest | Kiedy trafia do kontekstu | Do czego służy |
|---|---|---|---|
| Skill | plik z procedurą, wyzwalaczem i pułapkami | tylko przy pasującym zadaniu | powtarzalne zadania z wieloma krokami |
| Agent | wykonawca z narzędziami i własnym kontekstem | zawsze, gdy pracuje | wykonanie pracy, nie przechowywanie wiedzy |
| Zwykła rozmowa | wiadomości w jednej sesji | w trakcie sesji | jednorazowe zadanie, szybkie pytanie |
| Instrukcja projektu (CLAUDE.md, AGENTS.md) | zasady repozytorium lub folderu | zawsze, w tym miejscu pracy | standardy, których nie wolno złamać |
| Memory | krótkie, trwałe fakty o mnie i o środowisku | w każdym kontekście, od startu sesji | preferencje i fakty bez domu w zadaniu |
Agent to wykonawca, skill to instrukcja, którą wykonawca czyta. Agent bez skilla zrobi zadanie po swojemu i za każdym razem inaczej, a skill bez agenta zostaje tekstem na dysku.
Rozmowa znika po sesji i tak ma być, dopóki nie traktuję jej jak archiwum procedur. Instrukcja projektu działa inaczej: CLAUDE.md leży w repozytorium i Claude Code czyta go automatycznie w tym folderze (dostęp 2026-10-25).
Memory to trwałe fakty. W Hermesie pliki MEMORY.md i USER.md wchodzą do promptu systemowego w każdej sesji (dostęp 2026-10-25). Zła pamięć to lista kroków: zjada kontekst także wtedy, gdy procedura jest niepotrzebna.
Anatomia dobrego skilla: wyzwalacz, kroki, pułapki, przykłady, pliki pomocnicze
Skill, który działa, ma pięć części i każda odpowiada na inne pytanie. Napisałem kiedyś skilla bez pułapek i przykładów. Lądował w kontekście, ale agent i tak robił po swojemu, bo zabrakło mu informacji o tym, co się psuje.
Wyzwalacz to jedno zdanie w opisie, mówiące kiedy skill wchodzi. Musi opisywać sytuację, nie temat: „Sprawdza, czy nazwy plików IFC, PDF i DWG spełniają konwencję projektu przed wgraniem do CDE”. Agent czyta takie opisy na liście i po nich decyduje, czy otworzyć plik.
Kroki to numerowana lista działań w kolejności wykonania. Każdy krok ma być czasownikiem i wskazywać wejście: ścieżkę folderu, plik, komendę. Krok „przeanalizuj pliki” nic nie wnosi, a „uruchom skrypt na ścieżce folderu, nie na liście plików” zmienia wynik, bo skrypt sam wchodzi w podfoldery.
Pułapki to najcenniejsza i najczęściej pomijana część. Konkretne miejsca, w których zadanie się wykoleja, najlepiej z przykładem: polskie znaki w nazwie, brak zer wiodących, wielkość liter inna na Windowsie i na serwerze. Bez tego agent odkrywa te pułapki od nowa przy każdym uruchomieniu.
Przykłady pokazują wynik dobry i wynik do poprawy. Dwa wystarczą, bo dla modelu to kotwica formatu: widzi, że odpowiedź to lista nazw z powodem, a nie akapit wyjaśnień.
Pliki pomocnicze to skrypty, szablony i przykładowe dane obok SKILL.md. Ciało skilla mówi, kiedy je wywołać, i nie powtarza ich treści. Skrypt liczy i formatuje, skill tłumaczy po co. Poprawna nazwa pliku jest wtedy w jednym miejscu, w kodzie.
Trzy błędy, które psują skilla
Opis wyzwalacza zbyt szeroki. „Pomaga w pracy z plikami” wyzwala skilla przy każdej rozmowie o plikach, także wtedy, gdy procedura nie ma nic do rzeczy. Opis ma mówić o sytuacji i o wyniku, nie o dziedzinie.
Skopiowana treść zamiast procedury. Skill wypełniony fragmentami dokumentacji i długimi wyjaśnieniami ma teorię w środku, a kroki na końcu. Agent czyta cały plik, żeby znaleźć listę działań. Szczegóły idą do plików pomocniczych.
Brak weryfikacji. Skill bez zdania o tym, jak sprawdzić wynik, kończy się odpowiedzią, która wygląda dobrze i jest niepełna. U mnie to jedno zdanie: liczba plików dobrych plus liczba plików do poprawy musi równać się liczbie plików w folderze.
Jak napisać pierwszy skill w 20 minut
Pierwszy skill nie potrzebuje ram ani pięknej dokumentacji. Potrzebuje jednej procedury, którą wykonuję co najmniej raz w tygodniu, i 20 minut na zapisanie jej tak, jakbym tłumaczył ją nowemu człowiekowi w zespole.
- Wybieram procedurę i zapisuję jedno zdanie wyzwalacza. Test: czy kolega po przeczytaniu wie, kiedy ma po nią sięgnąć.
- Wypisuję kroki z ostatniego razu, w kolejności faktycznej. Wchodzi też krok wstydliwy, czyli „najpierw sprawdź, czy folder nie jest pusty”.
- Dopisuję pułapki: co poszło nie tak przy poprzednich dwóch próbach.
- Wklejam dwa przykłady, dobry i zły, z jednym zdaniem komentarza.
- Uruchamiam skilla na prawdziwym zadaniu i patrzę, czy agent zrobił to, co miał, bez dodatkowych pytań.
Jak sprawdzić, czy skill działa, i jak go poprawiać po użyciu
Test nie polega na czytaniu pliku. Daję agentowi zadanie, które ma wyzwolić skilla, i zadanie, które nie ma. Jeśli skill wchodzi w obu przypadkach, opis jest za szeroki. Jeśli nie wchodzi w żadnym, jest za wąski albo brzmi jak temat, a nie jak sytuacja.
Drugi test dotyczy wyniku. Puszczam to samo zadanie dwa razy na dwóch plikach i porównuję format odpowiedzi. Powtarzalny skill daje ten sam układ i kolejność informacji, a różnice w formie znaczą, że w kroku brakuje wzorca.
Poprawiam w tej samej sesji, w której zobaczyłem problem, i tylko w jednym miejscu. To, co agent zrobił inaczej niż chciałem, dopisuję jako pułapkę albo jako ostrzejszy krok. Jeśli poprawiam opis wyzwalacza za każdym użyciem, w środku siedzą dwie procedury i czas je rozdzielić.
Przykład: nowy skill demo, krok po kroku
Do tego wpisu napisałem nowy skill, nie ten z notatek: kontrola-nazw-plikow. Sprawdza, czy nazwy plików mają wszystkie pola konwencji przed wgraniem do CDE. Konwencja to uproszczona wersja tej z ISO 19650 po ludzku (dostęp 2026-10-25), sprowadzona do ośmiu pól. Struktura katalogu jest płaska i mieści się w trzech liniach:
kontrola-nazw-plikow/
  SKILL.md
  scripts/sprawdz-nazwy.py
  przyklady/przyklad-nazw.txt
SKILL.md zaczyna się od frontmattera z wyzwalaczem. Cały plik ma 1080 tokenów, więc po wyzwoleniu spokojnie mieści się w kontekście. Fragment poniżej pokazuje początek pliku razem z opisem, po którym agent decyduje sięgnąć po skilla:
---
name: kontrola-nazw-plikow
description: Use when checking whether IFC, PDF or DWG file names follow
  the project naming convention before a CDE upload. Runs a script that
  checks each field of the name and lists what is missing.
version: 1.0.0
---

## Kroki
1. Poproś o ścieżkę folderu, nie o listę plików.
2. Uruchom python3 scripts/sprawdz-nazwy.py <folder>.
3. Przeczytaj wynik: liczba plików, liczba dobrych, lista błędów.
4. Dla każdego błędu podaj poprawioną nazwę, nie sam komunikat.
5. Nie zmieniaj nazw sam. Zwróć listę i czekaj na zgodę.
Krok piąty jest tam z konkretnego powodu. Zmiana nazwy po wgraniu zrywa linki w modelu, więc automat zrobiłby więcej szkody niż pożytku. To pułapka przeniesiona do kroku, bo granica odpowiedzialności jest częścią procedury.
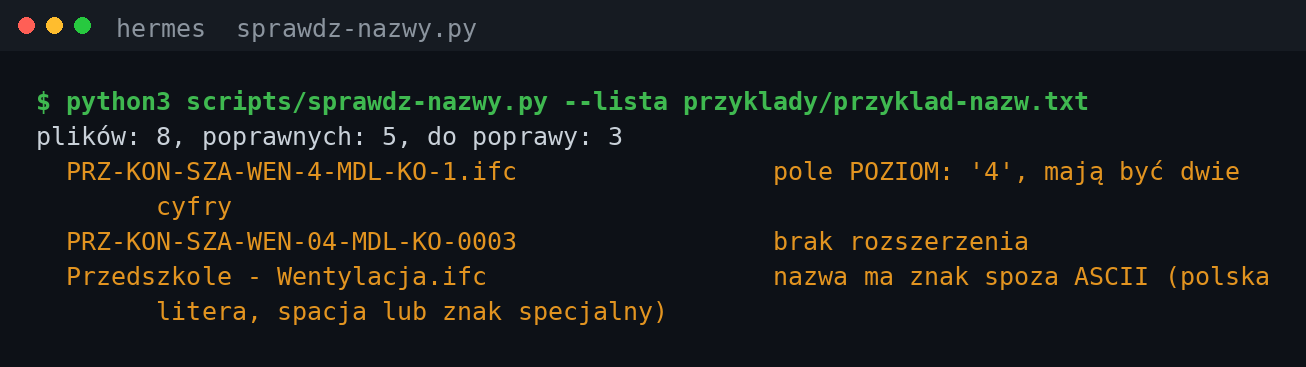
Skrypt sprawdza osiem pól i zwraca wynik w konsoli oraz w JSON. Na ośmiu przykładowych nazwach zgłasza pięć poprawnych i trzy do poprawy, z nazwą pola przy każdym błędzie.
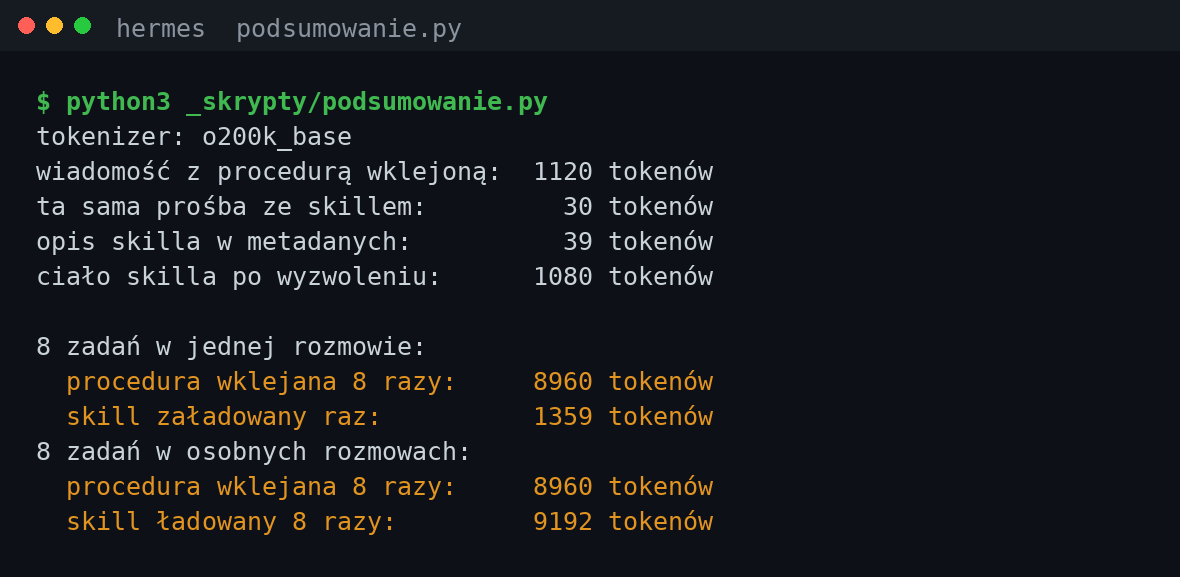
Teraz liczby. Zmierzyłem prompt tokenizerem o200k_base z pliku modelu gpt-4o (zmierzone 2026-10-25). Prośba „sprawdź nazwy plików w folderze” ma 30 tokenów, z wklejoną procedurą 1120, czyli o 1090 więcej. To 97,3 procent oszczędności na każdej wiadomości.
Przy ośmiu zadaniach w jednej rozmowie wklejanie procedury osiem razy daje 8960 tokenów, a skill załadowany raz to 1359 tokenów. W ośmiu osobnych rozmowach przewaga topnieje: skill ładowany osiem razy to 9192 tokeny, więcej niż wklejanie. Przy osobnych sesjach taniej wychodzi krótki tekst wklejony ręcznie.
Kiedy skill nie jest potrzebny
Skill kosztuje: trzeba go napisać i utrzymywać. Nie robię go z jednorazowego zadania, bo przeniesienie danych z arkusza, który nie wróci, nie zasługuje na plik. Nie robię go też z rzeczy, którą da się opisać jednym poleceniem.
Nie robię skilla z rzeczy, która zmienia się co tydzień. Cennik, lista kontaktów, aktualne stawki: to dane, nie procedura, więc ich miejsce to plik referencyjny albo pamięć. Zasada, która ma obowiązywać zawsze, na przykład język odpowiedzi, należy do instrukcji projektu.
Skill jest obowiązkowy, gdy powtarzalne zadanie z wieloma krokami ma pomyłki droższe niż napisanie pliku. Wtedy nie pytam, czy warto, tylko piszę go po drugim wykonaniu z rzędu. Więcej o budowie takich narzędzi napisałem w tekście Budowanie skilli dla inżynierów (dostęp 2026-10-25).
Źródła i czego nie sprawdziłem
Ładowanie skilli na żądanie sprawdziłem w dokumentacji systemu skilli Hermesa, hermes-agent.nousresearch.com/docs/skills (dostęp 2026-10-25). Pamięć trwałą w MEMORY.md i USER.md oraz czytanie CLAUDE.md opisuje dokumentacja pamięci projektu Claude Code, code.claude.com/docs/en/memory (dostęp 2026-10-25). Zalecenia o opisie wyzwalacza pochodzą z dokumentacji najlepszych praktyk tworzenia skilli, platform.claude.com/docs/en/agents-and-tools/agent-skills/best-practices (dostęp 2026-10-25).
Liczby tokenów zmierzyłem sam, skryptem z folderu materiałów, na plikach tego skilla demo (plik 2026-10-25-W31-pomiar-tokenow.json, 2026-10-25). Wpis nie zawiera kosztu w złotych, bo ten zależy od modelu i planu, a nie od skilla. Nie sprawdziłem też, jak zachowuje się ten skill w innym narzędziu niż Hermes, więc nie obiecuję, że zadziała wszędzie.
Sprawdź również:
- Bielik 11B v3.1: co naprawdę daje function calling
- Skille zamiast wklejania kontekstu
- Darmowe wtyczki do Revita 2026: MEP i koordynacja
- Jak utrzymać model 3D w Revicie w dobrej kondycji?
- BCF w projekcie: od kolizji do zamknięcia uwagi
Treść tego artykułu została stworzona z pomocą sztucznej inteligencji.