Przepłacasz wtedy, gdy mocny model robi robotę, którą tani zrobiłby tak samo dobrze. Trzy poziomy zadań, trzy pytania i dziennik, który koryguje progi.
Kiedy w skrzynce ląduje wątek dwunastu maili o przesunięciu terminu, sięgam po inny model niż wtedy, gdy czytam sześćdziesięciostronicową normę i szukam jednego punktu. Nie z przywiązania do narzędzi. Z rachunku: przy krótkim mailu różnica między tanim i mocnym modelem to kilka groszy, przy analizie normy kilkadziesiąt razy więcej, a płacenie pełnej stawki za pierwsze zadanie to najprostszy sposób, żeby mieć drogi nawyk i żadnej korzyści.
Przepłacasz wtedy, gdy drogi model robi zadanie, które tani model zrobiłby tak samo dobrze. Routing zadań to umiejętność dobrania modelu do roboty, nie do własnego przywiązania. W tym wpisie pokażę:
- trzy poziomy zadań i cztery przykłady z mojej pracy: streszczenie maila, ekstrakcję danych z PDF, analizę normy i decyzję projektową,
- trzy pytania, które rozstrzygają poziom w dziesięć sekund,
- kiedy tani model zawodzi i ile naprawdę kosztuje jego błąd,
- jak spiąć progi z routerem, żeby nie klikać tego ręcznie,
- jak prowadzić dziennik decyzji i kiedy poprawić próg, bo dane mówią, że jest ustawiony źle.
Ten wpis jest trzecią częścią serii o pracy z wieloma modelami. Poprzednie dotyczyły routera i darmowych modeli, następna będzie o pomiarze kosztu pojedynczego zadania.
Trzy poziomy zadań, czyli co naprawdę decyduje o cenie
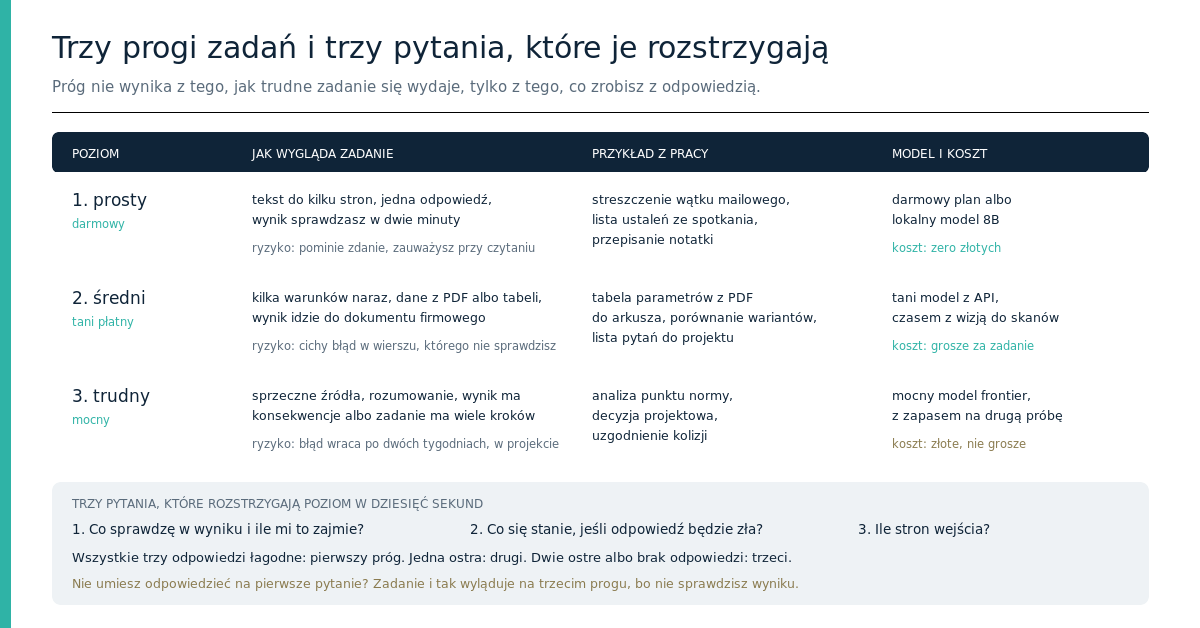
Cena nie zależy od tego, jak poważnie brzmi temat, tylko od tego, co zrobisz z odpowiedzią. Dwa zadania z tej samej dziedziny mogą różnić się kosztem trzydziestokrotnie, jeśli w jednym wynik sprawdzasz w dwie minuty, a w drugim idzie on do dokumentacji projektowej.
Poziom pierwszy: proste. Krótki tekst, jedna odpowiedź, wynik sprawdzasz wzrokiem. Streszczenie wątku mailowego z dwunastoma wiadomościami o przesunięciu terminu: kto podejmuje decyzję, jakie są nowe daty, czego brakuje. Albo lista ustaleń ze spotkania koordynacyjnego, spisana z moich własnych notatek. Model dostaje dwie strony tekstu i zwraca pół strony, którą czytam dwie minuty i od razu widzę, czy coś pominął, bo temat znam. Tu darmowy model albo lokalny 8B wystarcza, a koszt to zero złotych.
Poziom drugi: średni. Kilka warunków naraz, dane z PDF-a albo z tabeli, wynik idzie do dokumentu firmowego. Przykład: katalog urządzeń, czterdzieści stron, w środku tabela parametrów. Potrzebuję stu dwudziestu wierszy w arkuszu, w stałym formacie: oznaczenie, przepływ, wysokość podnoszenia, moc, masa. Model radzi sobie z tym dobrze, ale wynik trzeba sprawdzić, więc przeglądam dwanaście wierszy z setki. Tu tani model z API kosztuje grosze za zadanie i to jest właściwy wybór. Jeśli PDF jest skanem bez warstwy tekstowej, potrzebny jest model z wizją. O tym, jak wyciągać dane z dokumentów do notatek, pisałem w wpisie Jak przenieść PDF, Word i Excel do Obsidiana.
Poziom trzeci: trudny. Sprzeczne źródła, rozumowanie, wynik ma konsekwencje albo zadanie ma wiele kroków. Dwa przykłady. Pierwszy: analiza normy. Mam sześćdziesiąt stron i pytanie, czy mój wariant spełnia punkt 6.4.2. Tani model przeczyta i odpowie, tylko że odpowiedź bez cytatu z konkretnego punktu jest bezużyteczna, bo nie mam jak jej sprawdzić. Drugi: decyzja projektowa, na przykład wybór wariantu zasilania w budynku, gdzie cztery warunki są sprzeczne, a wynik idzie do klienta i zostaje w projekcie na dwa lata. Tu potrzebny jest mocny model, z zapasem na drugą próbę, i własna weryfikacja.
Warto zauważyć, że długość tekstu nie decyduje o poziomie. Stustronicowy raport, z którego wyciągam trzy liczby do tabeli, to poziom drugi. Jednostronicowa notatka z uzgodnień, na której podstawie zmieniam trasę instalacji, to poziom trzeci, mimo że tekstu jest mniej niż na ekranie.
Decyzja w dziesięć sekund: trzy pytania
Nie chodzi o to, żeby za każdym razem robić analizę. Chodzi o trzy pytania, na które odpowiadasz w myślach, zanim wkleisz tekst. Zajmuje to krócej niż wybór modelu z listy.
- Co sprawdzę w wyniku i ile mi to zajmie? Jeśli odpowiedź brzmi „przeczytam i zobaczę, czy się zgadza”, zadanie jest proste. Jeśli „będę porównywał z normą punkt po punkcie”, zadanie jest trudne, bo sprawdzenie kosztuje więcej niż wygenerowanie.
- Co się stanie, jeśli odpowiedź będzie zła? Poprawię i pójdę dalej, czy wróci po dwóch tygodniach w trakcie uzgodnień. Konsekwencja jest ważniejsza niż długość tekstu.
- Ile jest wejścia i ile kroków? Dwie strony czy osiemdziesiąt. Jedno pytanie czy dziesięć pytań, z których każde zależy od poprzedniego.
Reguła, którą stosuję: trzy odpowiedzi łagodne, pierwszy poziom. Jedna ostra, drugi. Dwie ostre albo brak odpowiedzi na pierwsze pytanie, trzeci. To ostatnie zdanie jest najważniejsze, bo jeśli nie umiesz powiedzieć, jak sprawdzisz wynik, to żaden model ci nie pomoże, a drogi model da ci tylko pewność siebie bez podstawy.
Jest jeszcze jedna pokusa, którą warto nazwać: wybieranie mocnego modelu na wszelki wypadek. Wygląda jak ostrożność, a jest unikiem. Jeśli każde zadanie idzie do najmocniejszego modelu, nigdy nie uczysz się sprawdzać wyników, bo zakładasz, że są dobre. Po pół roku nie masz ani oszczędności, ani nawyku weryfikacji, który w tej pracy jest ważniejszy od modelu.
Kiedy tani model zawodzi i ile to kosztuje
Tani model nie zawodzi tam, gdzie się go spodziewamy. Nie chodzi o to, że nie umie czytać. Chodzi o to, że nie przyznaje się do niepewności i nie sygnalizuje, kiedy wypadł mu fragment tekstu. Trzy rodzaje porażki, które widziałem u siebie.
Cichy błąd w liczbach. Ekstrakcja stu dwudziestu wierszy z katalogu: siedem wierszy przesuniętych o jedną kolumnę, bo w PDF-ie były scalone komórki. Model nie zgłosił wątpliwości, zwrócił równą tabelę. Błąd znalazłem po dwóch tygodniach przy zestawieniu, które nie chciało się zsumować. Koszt: godzina na znalezienie źródła i poprawki, przy oszczędności czterdziestu groszy na jednym zadaniu.
Obcięty kontekst w długim dokumencie. Odpowiedź oparta na pierwszych piętnastu stronach, sformułowana pewnie, bez informacji, że reszta wypadła. To najgorszy typ błędu, bo brzmi jak kompletna odpowiedź. Koszt: decyzja podjęta na niepełnym tekście, wykryta dopiero przy uzgodnieniach, kiedy trzeba wracać do wariantu.
Zadanie wielokrokowe. Po piątym kroku model gubi wątek, powtarza tę samą czynność albo zaczyna odpowiadać na inne pytanie. Pętla ciągnie się do wyczerpania limitu, a wynik jest pusty. Koszt: dwadzieścia minut i brak rezultatu, czyli najdroższa forma pracy.
Policzmy to na spokojnie. Dwadzieścia poprawek po piętnaście minut to pięć godzin w miesiącu. Jeśli z osiemset zadań miesięcznie sześćdziesiąt procent przechodzi z mocnego modelu na tani, a różnica to trzydzieści pięć groszy na zadaniu, oszczędność wynosi sto sześćdziesiąt osiem złotych. Wniosek nie jest taki, żeby przestać używać taniego modelu. Wniosek jest taki, że opłaca się go używać tam, gdzie jego błąd jest tani: w tekście, który przeczytasz, w danych, które sprawdzisz, w robocie, która nie idzie do klienta.
Druga strona rachunku jest mniej oczywista. Mocny model też się myli, tylko drożej. Jeśli nie masz zwyczaju sprawdzać, drogi model kupuje ci złudzenie, nie jakość. W pracy inżyniera różnica między modelem za grosze i modelem za złote jest mniejsza niż różnica między odpowiedzią sprawdzoną i niesprawdzoną.
Jak spiąć progi z routerem
Router modeli, czyli warstwa pośrednia między narzędziami a dostawcami, daje jedno miejsce, w którym definiuje się, kto odpowiada. Wystarczy nazwać kombinacje poziomami, a nie modelami. Zamiast „claude” i „deepseek” masz „poziom-1”, „poziom-2” i „poziom-3”. Nazwa mówi, o co prosisz, a nie kto odpowie, więc zmiana modelu w środku to jedna linia konfiguracji.
W praktyce wygląda to tak, że aplikacja prosi o poziom, nie o model. Trzy kombinacje, każda z inną logiką zapasu:
- Poziom pierwszy: darmowy model, potem tani płatny. Zapas jest tani, bo błąd jest tani.
- Poziom drugi: tani model, potem mocny. Tu zapas nie jest ozdobą, bo wynik idzie do dokumentu, więc gdy tani zwróci niepełną odpowiedź, próba idzie dalej.
- Poziom trzeci: mocny model, potem inny mocny model od innego dostawcy. Zapas tej samej klasy, bo obniżanie klasy w locie to dokładnie ten błąd, którego chcemy uniknąć.
Do tego dwa progi techniczne, które router potrafi wyegzekwować sam. Pierwszy: limit wejścia. Zadanie z wejściem powyżej dwudziestu tysięcy tokenów nie idzie do darmowego modelu, bo odpowiedź będzie oparta na fragmencie. Drugi: wymóg wizji. Jeśli wejściem jest skan, kombinacja musi mieć model, który czyta obrazy, niezależnie od tego, jak krótki jest dokument. Te dwa warunki wyłapują najczęstsze ciche błędy bez pytania cię o zdanie.
Czego nie automatyzować: decyzji o poziomie. Router nie wie, czy wynik idzie do klienta, czy do twojej notatki. Dopóki nie masz dziennika, o którym za chwilę, poziom wybieraj sam. Automatyczne klasyfikowanie zadań brzmi dobrze w prezentacji i psuje się na pierwszym zadaniu, które wygląda na proste, a ma konsekwencje. Jeśli routerem jest OpenRouter, podstawy konfiguracji opisałem w wpisie Claude za półdarmo, jak używać Claude Code przez OpenRouter z DeepSeek.
Dziennik decyzji i korekta progów
Progi ustawione na wyczucie są zgadywaniem i po dwóch tygodniach nikt nie pamięta, dlaczego jeden jest taki, a drugi inny. Dziennik nie musi być arkuszem z wykresami. Sześć kolumn i jeden wiersz na zadanie, wpis w dwadzieścia sekund.
- data,
- zadanie w trzech słowach, na przykład „tabela z katalogu”,
- poziom, który wybrałeś,
- model, który faktycznie odpowiedział, bo to często nie ten, o który prosiłeś, gdy zadziałał zapas,
- koszt zadania,
- ile minut poprawek i czy wynik przeszedł za pierwszym razem.
Przegląd raz w miesiącu, piętnaście minut. Jeśli z dwunastu zadań drugiego poziomu trzy wróciły z poprawkami, to dwadzieścia pięć procent, czyli próg jest za niski dla tego typu zadania i trzeba je przenieść wyżej. Tak wyglądała u mnie ekstrakcja z PDF-ów skanowanych: nie potrzebowała mocniejszego modelu tekstowego, tylko modelu z wizją. Próg nie był za niski, był źle opisany.
Korekta działa w obie strony i to jest część, którą łatwo pominąć. Jeśli zadania trzeciego poziomu przechodzą bez poprawek w ośmiu przypadkach na dziesięć, spróbuj jednego ich typu na tańszym modelu. Nie całej kategorii, jednego typu, przez dwa tygodnie. Inaczej nie będziesz wiedział, co zadziałało, a co tylko zbiegło się w czasie.
Zasada, która chroni ten dziennik przed rozrostem: jedna zmiana progu na dwa tygodnie. Kusi, żeby poprawiać wszystko naraz, zwłaszcza po pierwszym błędzie, ale wtedy dziennik przestaje cokolwiek tłumaczyć. Trzy tygodnie notowania to zwykle pierwszy moment, w którym widać, że połowa zadań, które wydawały się trudne, jest po prostu długa.
Routing zadań nie jest skomplikowaną technologią. To nawyk: nazwać zadanie, wybrać próg, zapisać wynik. Router daje miejsce, w którym ten nawyk da się utrzymać bez klikania przy każdym zapytaniu, a pomiar kosztu mówi, czy progi nadal pasują do cennika, który zmienił się w zeszłym tygodniu.
W kolejnej części serii policzę koszt pojedynczego zadania, razem z próbami, które nie doszły do skutku, bo cennik za milion tokenów nie odpowiada na pytanie, ile kosztowało to jedno zadanie. Jeśli chcesz zacząć wcześniej, wypisz trzy zadania, które robisz co tydzień, i przy każdym postaw pytanie o sprawdzalność wyniku. To wystarczy, żeby zobaczyć, gdzie przepłacasz. Listę takich powtarzalnych zadań z pracy inżyniera znajdziesz w wpisie AI dla inżyniera, ponad 40 praktycznych zastosowań.
Sprawdź również:
- Dane nieszablonowe w budownictwie: jak wyciągnąć dane z maili, notatek i PDF-ów
- Jaki komputer do Revita/BIM w 2026: CPU/GPU/RAM/SSD
- Case Study: jak uporządkować wiele skrzynek mailowych w jednym systemie (Thunderbird + AI)
- Chińskie modele AI: co dzieje się z danymi, które do nich wysyłasz
- Jak zwiększyć komfort pracy przy komputerze? Ergonomiczne stanowisko krok po kroku
Treść tego artykułu została stworzona z pomocą sztucznej inteligencji.