Sprawdzam, co Bielik 11B v3.1 daje w wywołaniach narzędzi: parser vLLM, walidację argumentów, benchmarki i wymagania sprzętowe.
Bielik 11B v3.1 obsługuje wywołania narzędzi, ale function calling nie jest funkcją modelu. To funkcja serwera vLLM z parserem SpeakLeash, a sam model zapisuje wywołanie jako tekst w znaczniku <tool_call>. Rozdzielam poniżej deklaracje producenta od tego, co da się sprawdzić.
Pracuję z modelami przez API i lokalnie od dwóch lat, a Bielika śledzę od wersji 11B v2. To nie poradnik instalacji, tylko odpowiedź na pytanie, kiedy wywołanie narzędzia jest wiarygodne.
Co przynosi wydanie z 10.11.2026
Wydanie z 10 listopada 2026 dodaje trzy rzeczy istotne dla pracy z narzędziami. Pierwsza to wywołania narzędzi w standardzie OpenAI przez vLLM z pluginami SpeakLeash, opisane w wpisie premiery i w repozytorium bielik-tools. Druga to odpowiedzi strukturalne przez response_format z json_schema i json_object. Trzecia to tryb rozumowania sterowany parametrem reasoning_effort, domyślnie wyłączony. Wszystkie trzy to deklaracje producenta bez niezależnych testów.
Reszta komunikatu to szersze tło: dodatkowe 500 mld tokenów pretreningu i rozszerzenie deklarowanego wsparcia z 32 do 56 języków. Metadane potwierdzają listę języków, ale nie dowodzą, że jakość polskiego tekstu się nie zmieniła.
Identyfikator modelu to speakleash/Bielik-11B-v3.1-Instruct, a licencja to Apache 2.0, co widać na karcie modelu. Sprawdziłem to ponownie 19 listopada 2026 przez API Hugging Face: pole licencji zwraca apache-2.0, a lista modeli organizacji posortowana po dacie zmiany pokazuje w połowie listopada wyłącznie nowe kwantyzacje wersji 3.0 i 2.6 oraz dwa modele Bielik-One oparte na wagach 3.1. Nowszego wydania 11B v3.1 Instruct nie ma, więc kontrola terminu publikacji wypada negatywnie.
Kolekcja v3.1 obejmuje wyłącznie modele 11B. Mniejsze Bieliki 4.5B i 1.5B zostały w linii v3.0, jak wynika z katalogu modeli. DFlash z 11 listopada to osobne wagi modelu draftowego, nie szybsza wersja tego samego modelu.
Jak działa function calling w modelu Bielik 11B
Model generuje wywołanie jako tekst w znaczniku, na przykład <tool_call>{"name":"get_weather","arguments":{"city":"Kraków"}}</tool_call>. To nie jest jeszcze pole tool_calls w odpowiedzi API, tylko zwykła treść, którą trzeba rozebrać. Format opisuje README repozytorium bielik-tools oraz przykład tool_calling.py.
Warstwą pośrednią jest vLLM z pluginem parsera. Parser narzędzi wydziela tool_calls, a parser rozumowania osobne pole reasoning. Wymagane jest vLLM 0.24 lub nowsze, producent opisuje testy na 0.32. Po tej konfiguracji odpowiedź wygląda jak z OpenAI, z tą różnicą, że działa tylko na tej jednej ścieżce.
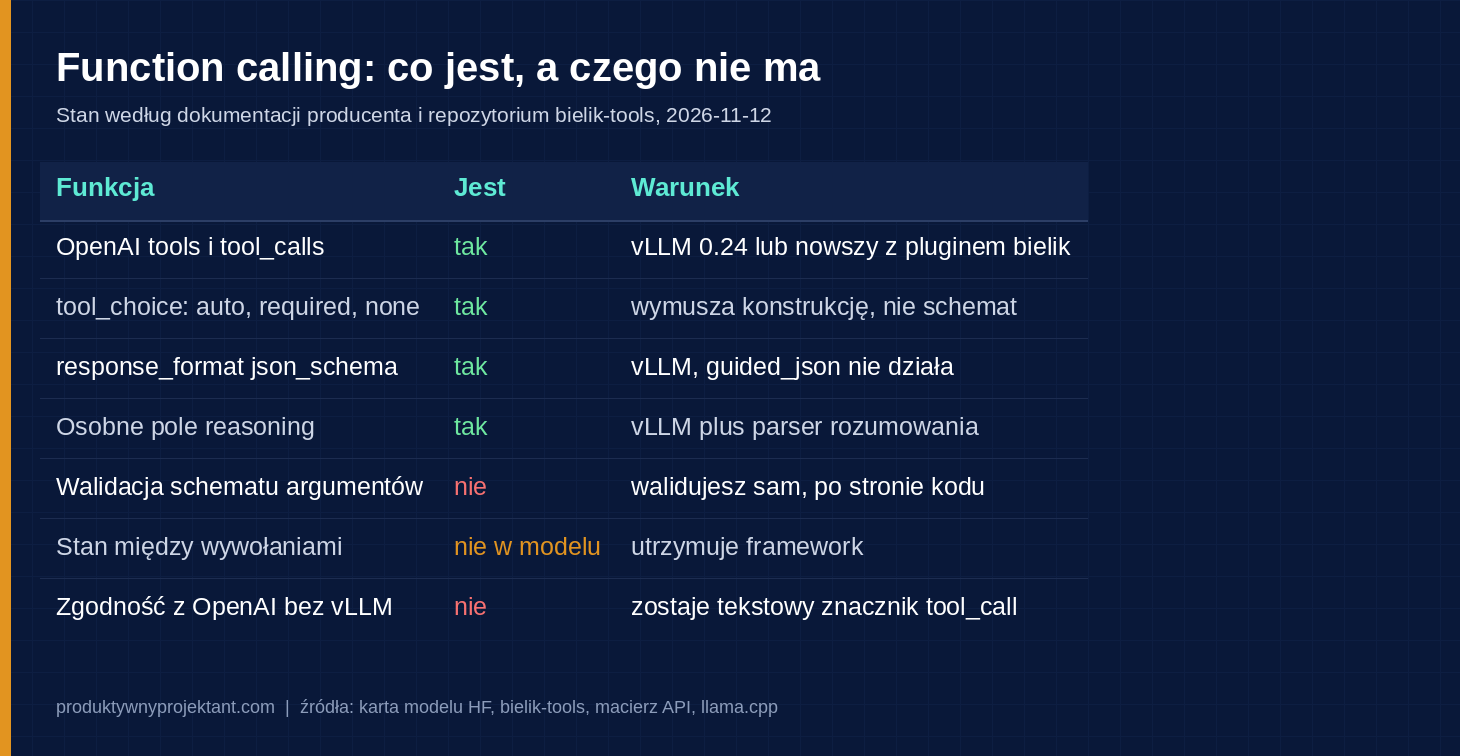
Trzy pułapki tej integracji są udokumentowane i każda psuje pracę po cichu. tool_choice i response_format nie trafiają automatycznie do szablonu czatu, więc trzeba je powtórzyć w chat_template_kwargs. Limit max_tokens obejmuje rozumowanie, więc model potrafi zużyć budżet w bloku myślenia i oddać puste content z finish_reason równym length. Tryb required wymusza konstrukcję wywołania, ale nie zgodność argumentów ze schematem, a zagnieżdżenie ma limit czterech poziomów.
Czwarta rzecz jest ograniczeniem ścieżki, nie pułapką. W llama.cpp Bielika nie ma na liście natywnych handlerów formatu czatu, więc trafia na ścieżkę generyczną z --jinja, a równoległe wywołania są tam domyślnie wyłączone. Opisuje to dokumentacja llama.cpp.
Co z benchmarków da się obronić, a co nie
Dla wersji 3.1 nie ma raportu technicznego ani tabeli wyników. Producent podaje wyłącznie różnice w komunikacie premierowym, bez wartości bezwzględnej, rozmiaru próby i metodyki. arXiv nie zwraca publikacji o Bieliku po 25 września 2026.
Kolumna „Kto podał” mówi, czy liczba pochodzi od producenta, czy z pomiaru niezależnego. „Brak wartości” znaczy, że nie ma czego porównywać, a link prowadzi do dokumentu źródłowego.
| Benchmark | Wersja | Wynik | Kto podał | Źródło |
|---|---|---|---|---|
| Belebele, średnia 28 języków europejskich | v3.0 | 82,98% | producent, raport techniczny | arXiv:2601.11579, tab. 13 |
| INCLUDE, podzbiór polski | v3.0 | 69,0% | producent, raport techniczny | arXiv:2601.11579, tab. 12 |
| Belebele, deklaracja premierowa | v3.1 | brak wartości, +8 pp wobec v3.0 | producent | wpis premiery |
| INCLUDE, deklaracja premierowa | v3.1 | brak wartości, +5 pp wobec v3.0 | producent | wpis premiery |
| tau2-bench, deklaracja premierowa | v3.1 | brak wartości, +16 do +45 pp | producent | wpis premiery |
| Belebele, polski | v3.1 | 86,56% | producent, odpowiedź w dyskusji | wątek dyskusji nr 2 |
| INCLUDE, polski | v3.1 | 72,67% | producent, odpowiedź w dyskusji | wątek dyskusji nr 2 |
| Belebele, polski | v3.1 | 85,67%, 771 z 900 | pomiar niezależny, Alpaczyk | wątek dyskusji nr 2 |
| INCLUDE, polski | v3.1 | 66,42%, 364 z 548 | pomiar niezależny, Alpaczyk | wątek dyskusji nr 2 |
| PolAgentBench, narzędzia po polsku | v3.0 Q4_K_M | 0,537, 36 z 67 | pomiar niezależny, Prejzner | arXiv:2609.32042 |
| Open PL LLM Leaderboard | v3.1 | brak wpisu | brak pomiaru | leaderboard |
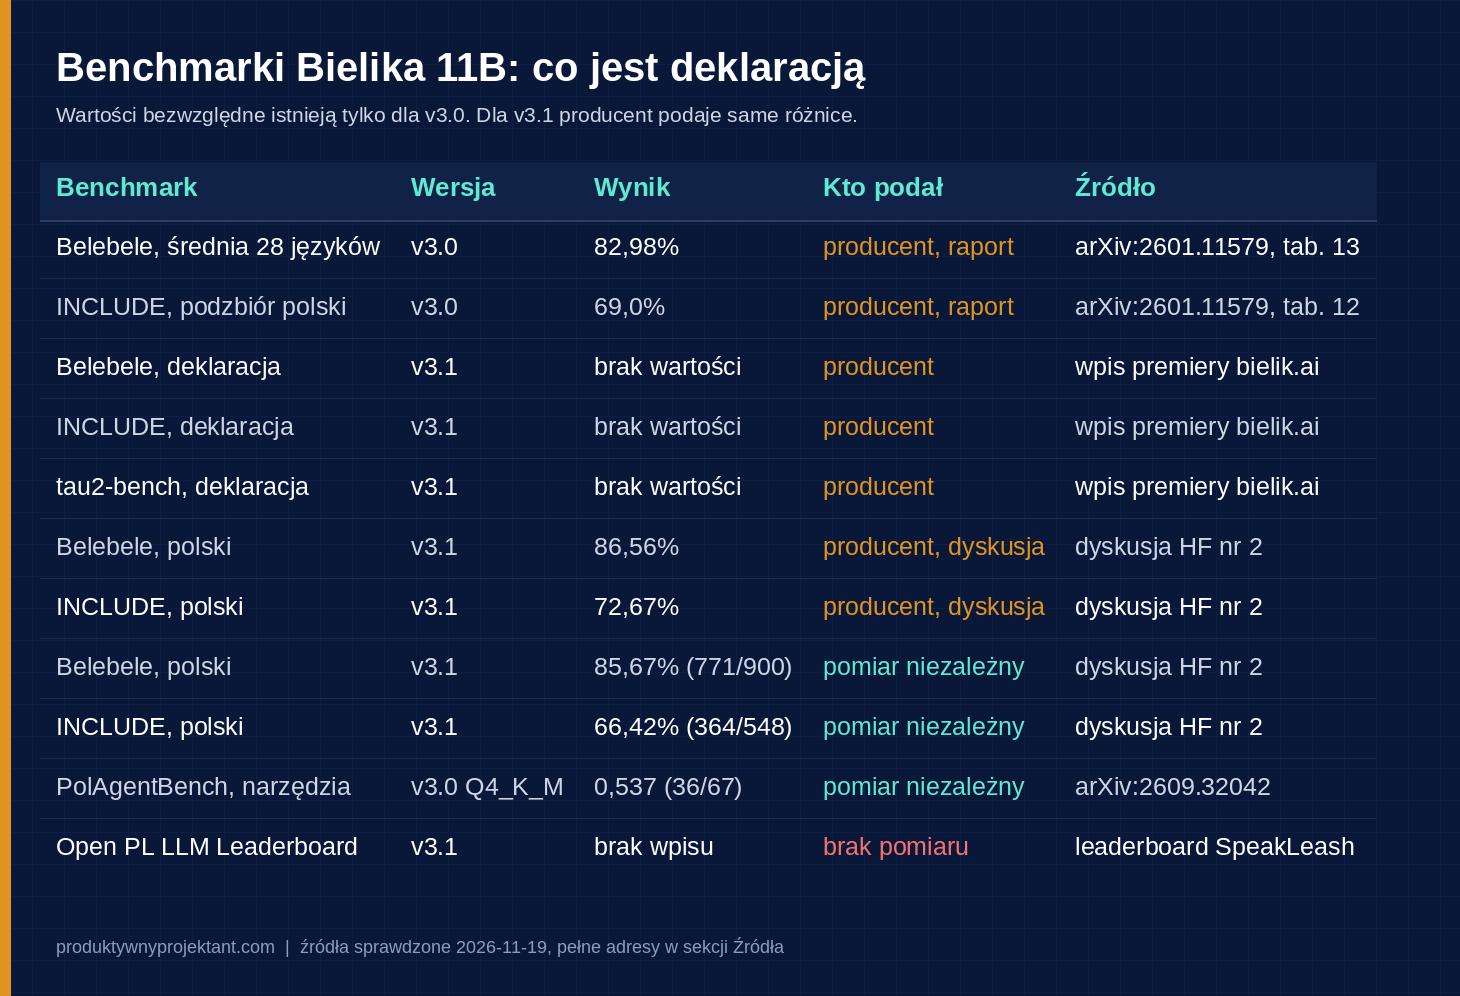
Dwa pierwsze wiersze tabeli to jedyne wartości bezwzględne, jakie w ogóle istnieją, i dotyczą wersji 3.0. Nie dodaję deklarowanych przyrostów do tabeli v3.0, bo dałoby to liczbę, której nikt nie zmierzył.
Najciekawszy wiersz to rozjazd na INCLUDE. Producent podaje 72,67%, niezależny pomiar 66,42%, czyli 6,25 punktu procentowego różnicy. To więcej niż dwukrotność błędu standardowego pomiaru niezależnego i przedziały ufności obu wyników się nie pokrywają. Przyczyna nie jest podana, a podejrzenie dotyczy szablonu czatu, którego pomiar niezależny nie użył. Na Belebele oba pomiary są zgodne w granicach punktu.
Trzy wnioski są mocniejsze niż jakakolwiek pojedyncza liczba. Wzrost INCLUDE o 5 punktów nie ma oparcia nawet w liczbach producenta, bo z 69,0 do 72,67 wychodzi 3,67. Sam niezależny pomiar pokazuje tam spadek o 2,58 punktu wobec v3.0. Tau2-bench bez wartości bazowej nie mówi nic, bo wzrost z 5 na 50 i z 45 na 90 to dwie różne informacje.
Osobno trzeba powiedzieć, czego w tabeli nie ma. PolAgentBench to jedyny niezależny pomiar wywołań narzędzi po polsku i dotyczy wersji 3.0, nie 3.1. Wynik 0,537 przy Q4_K_M oznacza 53,7%, czyli nieco ponad połowę zadań. Przenoszenie tej liczby na nowe wagi jest niedopuszczalne, bo v3.1 jest douczony właśnie pod agentów i nikt tego nie zmierzył.
Function calling w praktyce: argumenty to dane niezaufane
Karta modelu mówi wprost, żeby traktować argumenty narzędzi jako dane niezaufane, i to najważniejsze zdanie w tej dokumentacji. Powód jest prosty: poprawny JSON nie znaczy poprawne parametry. Model może podać datę, która nie istnieje, wartość spoza listy albo pole, którego schemat nie przewiduje.
Napisałem walidator, który robi to, co powinien robić kod po stronie narzędzia. Schemat wymaga tytułu od 3 do 80 znaków, terminu w formacie RRRR-MM-DD i priorytetu z listy trzech wartości. Pięć wywołań, jedno przyjęte, cztery odrzucone przed dotknięciem danych: data z kropkami, data nieistniejąca w kalendarzu, priorytet spoza listy i tytuł za długi z polem spoza schematu.
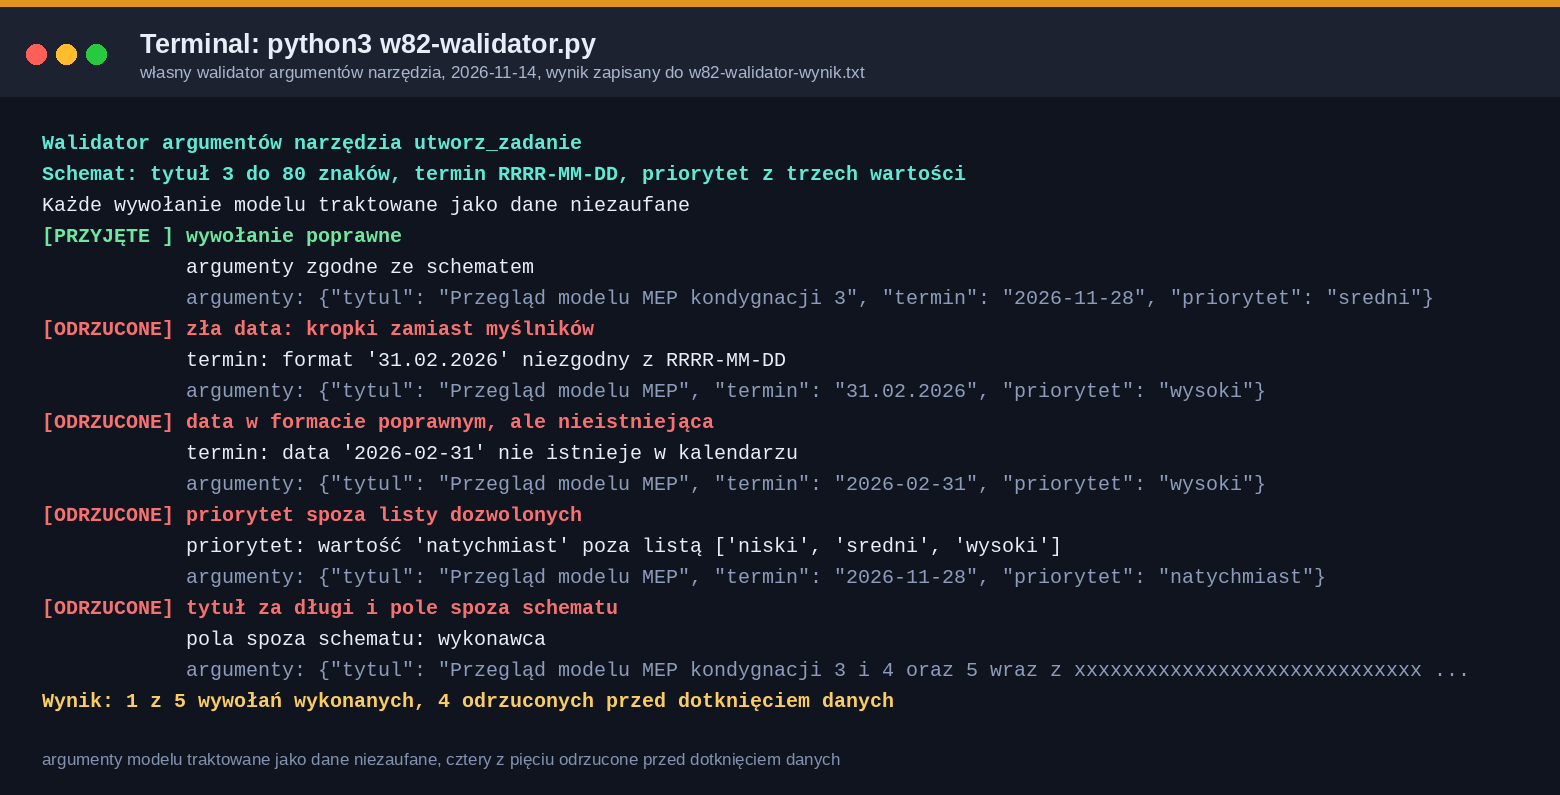
Data 2026-02-31 przechodzi kontrolę formatu, bo wygląda jak data, a nie istnieje. Model myli się tak często, bo daty są dla niego ciągiem znaków, a nie punktem na osi czasu.
Drugi powód walidacji jest poważniejszy. Argumenty funkcji przychodzą z tego samego miejsca co tekst użytkownika, więc podlegają tej samej klasie ataków. Jeśli narzędzie przyjmuje ścieżkę pliku i wykonuje open(argument), to wywołanie z ../../etc/passwd jest poprawne składniowo i katastrofalne w skutkach. Walidacja po stronie modelu nie istnieje, po stronie kodu jest obowiązkowa.
Czy nadaje się do pracy lokalnej: kiedy to nie zadziała
Na moim komputerze nie wchodzi, i to nie z powodu ceny. HP EliteDesk 800 G3 SFF ma procesor i7-7700, 15,5 GB pamięci widocznej i żadnej karty graficznej poza zintegrowaną. W chwili pomiaru 12 listopada 2026 dostępne było 8,8 GB. Plik Q4_K_M ma 6,7 GB, a szacowany RAM z kontekstem 8K to około 8,5 GB, czyli bez zapasu.
Tempo jest wyliczeniem, nie pomiarem, i mówię to raz wprost. Z przepustowości dwóch kanałów DDR4-2400 wynika teoretycznie 38,4 GB/s, przy efektywności 50 do 60% daje to 19 do 23 GB/s i prognozę 1,5 do 2,5 tokena na sekundę. Przy dwóch tokenach odpowiedź 150 tokenów trwa 75 sekund.
Dwa warunki są ważniejsze niż szybkość. Pierwszy to brak karty: ścieżka vLLM z parserami SpeakLeash wymaga rzędu 24 GB, bo tyle zajmuje ładowanie BF16 do FP8. Zostaje generyczna ścieżka llama.cpp, nieprzetestowana z moim frameworkiem. Drugi to kontekst: okno 32 768 tokenów nie znaczy, że zmieści się w 8,8 GB.
Dlatego nie wdrażam. Zostawiam deepseek-flash jako model roboczy kart, bo nic w zebranych danych nie uzasadnia zmiany, a opisane warianty to możliwości, nie krok do wykonania.
Kiedy Bielik ma sens
Trzy sytuacje uzasadniają lokalny model niezależnie od tempa. Pierwsza to dokumenty, które nie mogą opuścić środowiska: umowy z klauzulą poufności, dane osobowe, dokumentacja objęta umową. Jeśli wysłanie tekstu do dostawcy API wymaga zgody prawnej, której nie ma, szybkość przestaje być argumentem.
Druga to praca bez internetu: budowa, hala produkcyjna, serwerownia bez zewnętrznego łącza. Model lokalny działa tam, gdzie API nie odpowiada wcale.
Trzecia to zadania wsadowe przez noc: klasyfikacja partii dokumentów, wyciąganie danych z faktur, streszczanie archiwum. Maszyna pracuje bez nadzoru, nikt nie czeka na odpowiedź, a liczy się przepustowość na dobę.
Polski jest argumentem słabszym, niż się wydaje. Otwarta licencja i polskie dane treningowe to zaleta przy polskich dokumentach, ale nie ma niezależnej oceny jakości polskiej prozy tej wersji, a testy wielokrotnego wyboru nie mierzą stylu.
Jak sprawdzić samemu w 20 minut
Procedura mieści się w pięciu krokach i nie wymaga konta ani karty. Pobierz plik Q4_K_M z repozytorium GGUF, to 6,7 GB. Uruchom llama-server z --jinja i kontekstem jawnie ustawionym na 4096 tokenów.
Potem cztery testy, każdy odpowiada na inne pytanie. Pierwszy: wyślij żądanie z definicją jednej funkcji i sprawdź, czy w odpowiedzi jest pole tool_calls, czy znacznik <tool_call> w treści. Drugi: podaj schemat z trzema polami i pięć razy poproś o wywołanie, w tym raz z wartością spoza listy. Policz, ile razy model wyszedł poza schemat.
Trzeci test mierzy tempo, nie opinię. Wygeneruj 300 tokenów, zmierz czas zegarkiem i podziel. Jeśli wyjdzie poniżej dwóch tokenów na sekundę, odpowiedź o pracy interaktywnej masz gotową. Czwarty jest najbliżej realnej pracy: polskie polecenie i schemat z angielskimi nazwami pól, na przykład normalizacja Łodzi na Łódź i osiemdziesięciu na 80.
W wyniku szukaj trzech rzeczy: czy finish_reason to tool_calls przy wymuszonym wywołaniu, czy pole reasoning jest osobno, i czy puste content występuje częściej niż raz na dziesięć wywołań. Puste content przy finish_reason równym length znaczy, że budżet tokenów zjadło rozumowanie, a nie że model odmówił.
Werdykt
Z tego wydania biorę trzy rzeczy: standard OpenAI w wywołaniach narzędzi przez vLLM, odpowiedzi strukturalne ze schematem i rozumowanie z jawnym budżetem tokenów. To konkretne elementy integracji, a nie hasło o modelu agentowym.
Na co czekam: na raport techniczny z wartościami bezwzględnymi, na wpis v3.1 w Open PL LLM Leaderboard i na powtórzenie PolAgentBench na nowych wagach. Do tego czasu zdanie o lepszym polskim opiera się na deklaracji różnicy bez punktu odniesienia.
Czego nie robię: nie wdrażam Bielika lokalnie do pracy interaktywnej, nie kupuję karty bez konkretnego dokumentu i nie powtarzam procentów producenta jako faktu. Kontrola źródeł 19 listopada 2026 nie wykazała nowszego wydania, ale publikacja wypada po 26 listopada, po Bielik Summit, i wtedy trzeba sprawdzić jeszcze raz.
Jeśli chcesz najpierw obniżyć rachunek po stronie API, zajrzyj do wpisu o oszczędzaniu tokenów. Jeśli zastanawiasz się, kiedy subskrypcja wygrywa z rozliczeniem za token, przeczytaj o subskrypcji AI. O danych wysyłanych do modeli z Chin piszę osobno w tekście o chińskich modelach.
Jak powstał ten materiał
Podstawa to dokumentacja producenta, repozytorium bielik-tools, karta modelu na Hugging Face i niezależne pomiary z 12 listopada 2026, sprawdzone 19 listopada. Wag nie pobierałem i modelu nie uruchamiałem, więc liczby o szybkości są wyliczeniem. Uruchomiłem własny walidator argumentów, jego wynik jest na zrzucie.
Źródła
- Wpis premiery Bielik 11B v3.1, bielik.ai (producent)
- Karta modelu v3.1, Hugging Face (producent)
- Kolekcja v3.1, Hugging Face (producent)
- Wariant GGUF Q4_K_M, Hugging Face (producent)
- Lista modeli SpeakLeash, API Hugging Face (producent)
- Repozytorium bielik-tools, GitHub (producent)
- Macierz zgodności API, bielik-tools (producent)
- Przykład tool_calling.py, bielik-tools (producent)
- Wątek dyskusji nr 2, Hugging Face (pomiar niezależny i producent)
- Raport techniczny Bielik 11B v3, arXiv:2601.11579 (producent)
- Quantization Thresholds Replicate, Failure Modes Do Not, arXiv:2609.32042 (niezależne)
- Publikacje o Bieliku, arXiv (metadane)
- Open PL LLM Leaderboard, SpeakLeash (producent)
- Katalog modeli, bielik.ai (producent)
- Function calling w llama.cpp (producent narzędzia)
- Karta modelu z szacunkami, llmconfigurator.com (zewnętrzne, niezweryfikowane)
Sprawdź również:
- Bielik 11B v3.1: co naprawdę daje function calling
- Skille zamiast wklejania kontekstu
- Darmowe wtyczki do Revita 2026: MEP i koordynacja
- Jak utrzymać model 3D w Revicie w dobrej kondycji?
- BCF w projekcie: od kolizji do zamknięcia uwagi
Treść tego artykułu została stworzona z pomocą sztucznej inteligencji.