Router modeli to jedna warstwa między Twoimi narzędziami a dostawcami AI. Pokazuję, co daje kombinacja modeli, jak zacząć bez przebudowy narzędzi i kiedy lepiej zostać przy jednym modelu.
Jeszcze niedawno każde narzędzie z AI miało własne miejsce na dostawcę i klucz. Asystent w terminalu, wtyczka w edytorze, skrypt porządkujący pliki w nocy. Kiedy model zaczynał zwracać błędy limitu, zmiana w jednym miejscu pociągała za sobą trzy pozostałe, a po tygodniu nikt nie wiedział, która konfiguracja jest aktualna.
Lokalny router modeli rozwiązuje dokładnie ten problem. To warstwa, przez którą przechodzi każde zapytanie: aplikacje wysyłają je w jedno miejsce, a router decyduje, do którego modelu trafi. W tym wpisie pokażę:
- czym jest proxy LLM i co realnie zmienia,
- co daje router: kombinacje modeli, zapas i jeden klucz dla wielu dostawców,
- jak wygląda droga zadania od aplikacji do odpowiedzi,
- jak zacząć w jedno popołudnie, bez przebudowy narzędzi,
- kiedy router się nie opłaca i lepiej zostać przy jednym modelu,
- co dalej, czyli jak połączyć go z routingiem zadań i pomiarem kosztu.
To pierwszy wpis z serii czterech. Trzy pozostałe zapowiadam na końcu.
Proxy, czyli ktoś musi stać w środku
Proxy LLM to usługa, która stoi między aplikacją a dostawcą modelu. Aplikacja wysyła zapytanie w formacie, który zna, najczęściej zgodnym z tym, co zaproponowało OpenAI. Proxy tłumaczy je na format docelowego modelu, przekazuje dalej i zwraca odpowiedź w formacie, którego oczekuje aplikacja.
Problem, który to rozwiązuje, jest czysto rachunkowy. Pięć narzędzi i trzech dostawców to piętnaście miejsc do utrzymania, jeśli każde narzędzie zna każdego dostawcę osobno. Zmiana modelu, ceny albo klucza wymaga przejścia przez wszystkie. W praktyce kończy się to tak, że część narzędzi zostaje na starym modelu, bo nikt nie pamięta, gdzie jeszcze siedzi.
Najprostsza analogia jest z instalacji elektrycznej. Tablica rozdzielcza nie produkuje prądu, ale decyduje, co jest podłączone do którego obwodu i co się stanie, gdy jeden bezpiecznik wywali. Router modeli robi to samo z zapytaniami: nie generuje odpowiedzi, tylko kieruje zadanie i decyduje, co się dzieje przy awarii.
Warto od razu powiedzieć, czego router nie robi, bo łatwo przypisać mu więcej, niż może. To nie jest model i nie dodaje jakości. Jeśli model nie umie czegoś zrobić, router tego nie naprawi. Zmienia tylko sposób, w jaki zadanie trafia do modelu, i to jest cała jego rola.
W praktyce spotkasz dwa warianty. Pierwszy to agregator w chmurze: jeden klucz, wiele modeli, zero instalacji, ale zapytania przechodzą przez cudzy serwer i płacisz za wygodę. Drugi to lokalna instancja routera: klucze zostają u Ciebie, możesz podłączyć dostawców zewnętrznych i modele działające na Twoim komputerze. O stronie chmurowej pisałem szerzej we wpisie Claude za półdarmo, jak używać Claude Code przez OpenRouter z DeepSeek.
Co daje lokalny router modeli: kombinacja, zapas, jeden klucz
Trzy rzeczy robią tu najwięcej roboty i wszystkie trzy sprowadzają się do tego, że decyzja przenosi się z aplikacji do jednego miejsca.
Kombinacja modeli (combo). To lista modeli w kolejności priorytetów, ukryta pod jedną nazwą. Nazwa opisuje zadanie, nie model: szybkie, kod, analiza. Aplikacja prosi o szybkie i nie wie, kto odpowie. Zmiana modelu w kombinacji to jedna linia, a nie pięć programów.
Zapas. Gdy pierwszy model zwróci błąd limitu, przekroczy czas oczekiwania albo zwróci pustą odpowiedź, router sam bierze następną pozycję z listy. Aplikacja dostaje odpowiedź i nie musi wiedzieć, że pierwsza próba nie wyszła. To brzmi jak drobiazg, dopóki nie pracujesz z zadaniem, które ma się wykonać w nocy bez nadzoru.
Jeden klucz. Narzędzia dostają jeden adres i jeden klucz lokalny. Prawdziwe klucze dostawców zostają w routerze, w jednym miejscu, więc ich rotacja to jedna operacja, a nie spacer po ustawieniach. Minus jest oczywisty: to także jedno miejsce, które trzeba chronić.
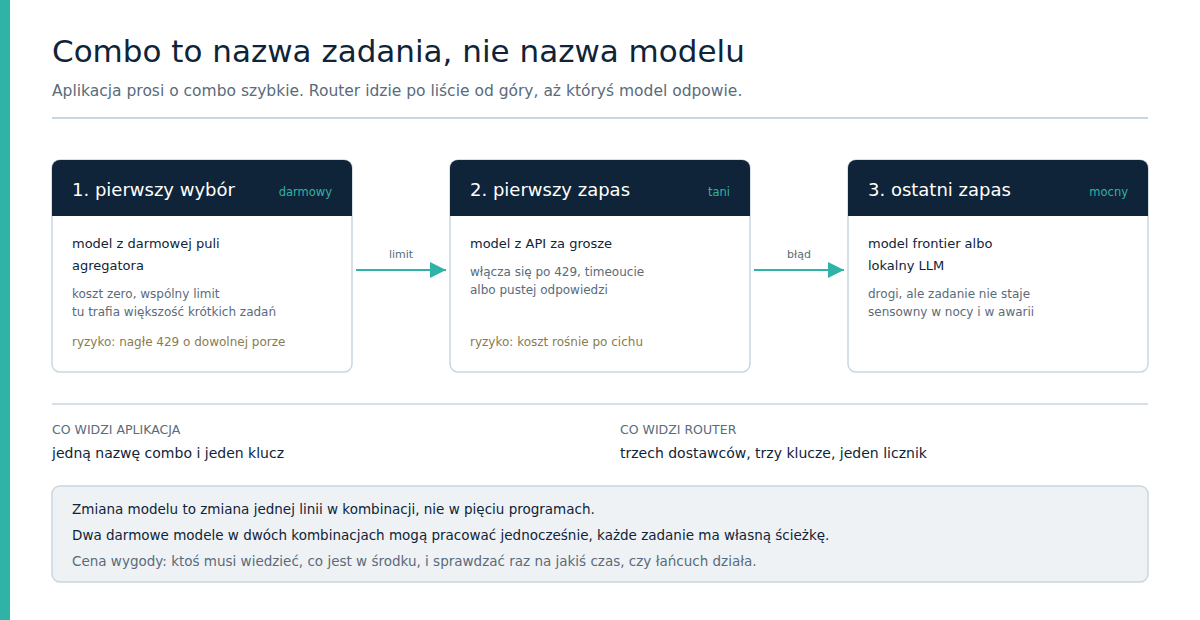
Najciekawsza część to darmowe modele. Mają wspólne limity i potrafią odmówić o dowolnej porze, bez ostrzeżenia. Jeśli w routerze stoi kilka darmowych modeli, mogą pracować równolegle: tłumaczenie dokumentacji idzie do jednego, klasyfikacja maili do drugiego, streszczenie notatek do trzeciego. Wyczerpany limit jednego nie zatrzymuje całości, bo router przechodzi do następnego darmowego, zamiast od razu sięgać po płatny.
W praktyce wygląda to tak, że rano w logach widzisz, ile zadań poszło darmowo, a które wymagały płatnego modelu. Bez routera ta informacja nie istnieje, bo nikt nie zapisuje, ile razy w nocy model odmówił.
| Co robi router | Czego nie zrobi |
|---|---|
| wybiera model według reguły z kombinacji | nie poprawi słabego modelu ani złego promptu |
| przechodzi do zapasu po błędzie lub limicie | nie obejdzie limitów subskrypcji |
| trzyma klucze dostawców w jednym miejscu | nie zastąpi klucza odpowiednim uprawnieniem |
| zapisuje zużycie na zadanie | nie policzy kosztu, jeśli nikt tego nie czyta |
| ujednolica format zapytań | nie zagwarantuje, że odpowiedź będzie prawdziwa |
Jak wygląda przepływ zadania
Cały mechanizm jest krótszy, niż się wydaje. Pięć kroków, z których aplikacja widzi tylko pierwszy i ostatni.
- Aplikacja wysyła zapytanie na lokalny adres routera, w znanym sobie formacie, z nazwą kombinacji zamiast nazwy modelu.
- Router sprawdza klucz lokalny, bierze pierwszą pozycję z kombinacji i tłumaczy zapytanie na format tego dostawcy.
- Dostawca odpowiada. Jeśli odpowiedź jest poprawna, router zwraca ją aplikacji w formacie wyjściowym.
- Jeśli odpowiedź nie przyszła albo przyszła z błędem, router zapisuje zdarzenie, bierze następną pozycję z listy i powtarza próbę.
- Na koniec router zapisuje, ile tokenów poszło, do którego modelu i w jakim zadaniu.
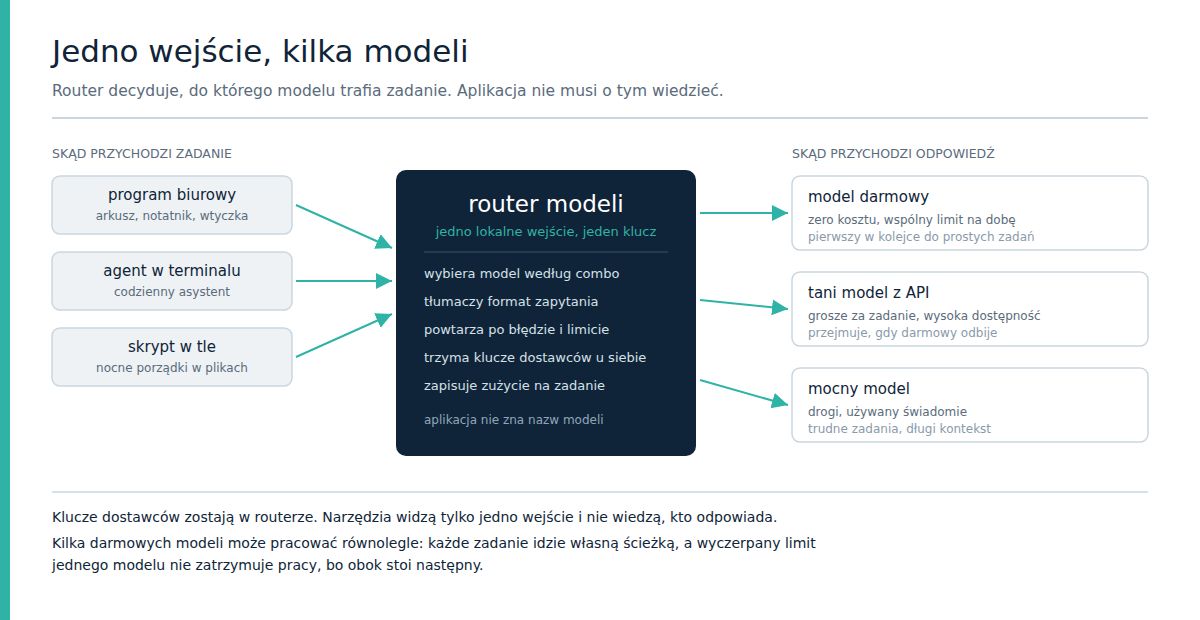
Ta wymiana dzieje się w milisekundach, bo router stoi na tym samym komputerze co aplikacja. Nie zauważysz różnicy w czasie odpowiedzi, bo i tak dominuje czas generowania tekstu przez model. Jeśli router stoi na innym urządzeniu w sieci, nadal mówimy o opóźnieniu mniejszym niż sekunda.
Wartość jest w tym, co zostaje po zadaniu. Log pokazuje, które zadanie trafiło do płatnego modelu mimo darmowej kombinacji, ile razy darmowy model odmówił i o której godzinie. To dane, na których później buduje się routing zadań i pomiar kosztu, czyli dwie kolejne części tej serii.
Jak zacząć bez przebudowy narzędzi
Nie zaczynaj od instalacji. Zacznij od listy narzędzi, z których naprawdę korzystasz, i sprawdź, które pozwalają zmienić adres API. Prawie wszystkie pozwalają, a te, które nie pozwalają, zostają poza routerem i nie jest to problem.
Potem wybierz jedną z trzech dróg wejścia. Różnią się nakładem i tym, ile kontroli dostajesz w zamian.
Jeśli wybierasz drogę lokalną, nazwy konkretnych narzędzi są drugorzędne. Warto wiedzieć, że takich routerów jest kilka i robią w gruncie rzeczy to samo: OmniRoute, LiteLLM, New API. Różnią się oprawą, sposobem konfiguracji i tym, jak szybko nadążają za zmianami u dostawców.
| Wariant | Co dostajesz | Czego brakuje |
|---|---|---|
| agregator w chmurze | jeden klucz, wiele modeli, zero instalacji | zapytania idą przez cudzy serwer, płacisz za wygodę |
| lokalny router open source | klucze u siebie, własne modele lokalne, pełna kontrola | trzeba utrzymać usługę i jej aktualizacje |
| wspólny plik konfiguracji | najmniejszy nakład pracy | działa przy dwóch narzędziach, przy pięciu przestaje |
Jeśli wybierasz lokalny router, kolejność działań jest zawsze taka sama i nie zależy od tego, które oprogramowanie wybierzesz.
- Wybierz dwa albo trzy modele: darmowy, tani i mocny. Więcej na start tylko zaciemnia obraz.
- Nazwij kombinacje po zadaniach, nie po modelach. Szybkie, kod, analiza. Nazwa modelu w środku i tak się zmieni.
- Ustaw kolejność od najtańszego. Jeśli darmowy model poradzi sobie z zadaniem, płatny nie powinien w ogóle startować.
- Przetestuj awarię: wyłącz pierwszy model w kombinacji i sprawdź, czy zadanie przechodzi dalej. To jedyny test, który naprawdę coś sprawdza.
- Dopiero potem podłączaj kolejne narzędzia. Jedno narzędzie na raz, żeby wiedzieć, co przestało działać, gdy coś przestanie.
- Zrób kopię konfiguracji. To teraz jeden plik, od którego zależy cała praca.
O bezpieczeństwie dwa zdania, bo temat wraca. Router trzyma wszystkie klucze w jednym miejscu, co jest wygodne i ryzykowne jednocześnie: jedno miejsce do rotacji, ale też jedno miejsce do ochrony. Jeśli działa lokalnie i nie jest wystawiony poza Twój komputer, ryzyko jest małe. Wystawianie go do sieci ma sens tylko wtedy, gdy wiesz, jak go zabezpieczyć.
Całość to jedno popołudnie, nie tydzień. Najwięcej czasu zajmuje nie instalacja, tylko testy: sprawdzenie, czy każde narzędzie faktycznie rozmawia z routerem i czy zapas działa wtedy, gdy jest potrzebny.
Kiedy to się nie opłaca
Router to dodatkowa warstwa i trzeba ją utrzymać. W kilku sytuacjach kosztuje więcej, niż daje, i nie ma sensu udawać, że jest inaczej.
- Jedno narzędzie i jeden model. Jeśli nie planujesz drugiego dostawcy, wystarczy klucz wpisany w ustawieniach. Router zaczyna zarabiać na siebie dopiero przy drugim narzędziu albo drugim modelu.
- Praca wyłącznie z subskrypcji. Router nie obejdzie limitów abonamentu. Claude Pro czy ChatGPT Plus rozliczają pracę inaczej niż API i żadna warstwa pośrednia tego nie zmieni.
- Wymogi audytowe. Jeśli klient albo dział zgodności wymaga wskazania konkretnego modelu i miejsca przetwarzania danych, dodatkowa warstwa komplikuje dowód. Nie uniemożliwia go, ale trzeba ją opisać w dokumentacji.
- Brak czasu na utrzymanie. Dostawcy zmieniają formaty i wycofują modele bez długiego ostrzeżenia. Jeśli nie masz zwyczaju zaglądać do konfiguracji raz na miesiąc, prostszy układ będzie trwalszy.
- Praca tylko na modelach lokalnych. LM Studio daje jedno API dla wszystkich lokalnych modeli, więc router niewiele dodaje, dopóki nie chcesz łączyć modeli lokalnych z chmurowymi. O ustawieniach LM Studio pisałem w wpisie LM Studio, optymalizacja lokalnych LLM.
Żadna z tych sytuacji nie jest porażką routera. Po prostu nie każdy problem wymaga tej warstwy, a dokładanie infrastruktury na zapas to najczęstszy sposób na to, żeby przestać używać własnych narzędzi.
Co dalej: routing zadań i pomiar kosztu
Router odpowiada na pytanie, jak zadanie trafia do modelu. Nie odpowiada na dwa ważniejsze: które zadanie powinno iść do którego modelu i ile to naprawdę kosztuje.
Pierwsze to routing zadań: reguły, według których krótkie tłumaczenie nie potrzebuje najmocniejszego modelu, a analiza umowy nie powinna iść do darmowego z limitem na dobę. Drugie to pomiar kosztu: nie cena za milion tokenów z cennika, tylko koszt konkretnego zadania, razem z próbami, które nie doszły do skutku.
W kolejnych wpisach serii:
- darmowe modele: skąd je brać, jak sprawdzać limity i jak nie tracić czasu na te, które zaraz znikną,
- routing zadań: reguły podziału pracy między modele i przykład z codziennej pracy inżyniera,
- pomiar kosztu: jak policzyć koszt zadania i co zrobić z tą liczbą.
Jeśli router to tablica rozdzielcza, to routing jest projektem instalacji, a pomiar kosztu licznikiem. Osobno każde z nich jest użyteczne. Razem tworzą układ, który da się utrzymać bez codziennego pilnowania.
Jeśli korzystasz z kilku modeli i już raz przepisywałeś konfigurację w kilku miejscach, zacznij od listy narzędzi i jednej kombinacji. To wystarczy, żeby sprawdzić, czy ta warstwa ma dla Ciebie sens, bez przebudowy całego warsztatu.
Sprawdź również:
- Dane nieszablonowe w budownictwie: jak wyciągnąć dane z maili, notatek i PDF-ów
- Jaki komputer do Revita/BIM w 2026: CPU/GPU/RAM/SSD
- Case Study: jak uporządkować wiele skrzynek mailowych w jednym systemie (Thunderbird + AI)
- Chińskie modele AI: co dzieje się z danymi, które do nich wysyłasz
- Jak zwiększyć komfort pracy przy komputerze? Ergonomiczne stanowisko krok po kroku
Treść tego artykułu została stworzona z pomocą sztucznej inteligencji.