Ten sam dokument jako tekst kosztuje 3,3 razy mniej niż jako czterdzieści zdjęć stron. Mierzę tokeny, koszt i ryzyko dla tekstu, PDF-a i obrazów, a na końcu daję checklistę.
SEO: DO PRZENIESIENIA DO YOAST
Meta description (120-140 znakow): Tokeny kosztują głównie przez to, co wysyłasz. Mierzę dokument 40 stron jako tekst, PDF i zdjęcia oraz podaję checklistę oszczędzania.
Focus keyphrase: oszczędzanie tokenów
SEO title (50-60 znakow): Oszczędzanie tokenów w pracy z AI: co wysyłasz, to płacisz
Oszczędzanie tokenów zaczyna się od decyzji, co wysyłasz, a nie od wyboru modelu. Ten sam dokument wysłany jako tekst kosztuje u tego samego modelu 3,3 razy mniej niż wysłany jako czterdzieści zdjęć stron. Poniżej pokazuję pomiary z 25 października 2026, policzone na dokumencie demonstracyjnym o 40 stronach.
W tym wpisie pokażę:
- skąd bierze się koszt i dlaczego historia rozmowy wraca przy każdym pytaniu,
- ile kosztuje ten sam dokument jako tekst, jako PDF i jako zdjęcia stron,
- co daje prompt w systemie KARTKA i czego nie daje caveman,
- jak wybrać model do zadania i kiedy warto przenieść procedurę do skilla,
- checklistę dziesięciu punktów, którą można przejść w jedno popołudnie.
Skąd bierze się koszt: wejście, wyjście i powtarzany kontekst
Każde zapytanie do modelu to dwa strumienie tokenów. Wejście to wszystko, co model czyta: twoje pytanie, historia rozmowy, wklejone pliki i prompt systemowy. Wyjście to odpowiedź, którą dostajesz.
Cenniki różnicują te strumienie i warto znać proporcję. Model gpt-6-luna kosztuje 0,10 USD za milion tokenów wejścia i 0,50 USD za milion tokenów wyjścia (lista modeli OpenRouter, cennik sprawdzony 2026-10-25). Wyjście jest droższe pięciokrotnie, ale to wejście decyduje o rachunku przy pracy z dokumentami.
Drugi mechanizm jest mniej widoczny. Każde kolejne pytanie w tym samym wątku wysyła ponownie całą wcześniejszą rozmowę, bo model nie pamięta niczego między zapytaniami. Dwadzieścia tysięcy tokenów historii i dziesięć tur to dwieście tysięcy tokenów wejścia. Ze stu osiemdziesięciu tysięcy z tego powodu nie czytasz ani razu, bo to te same zdania wysłane drugi, trzeci i dziesiąty raz.
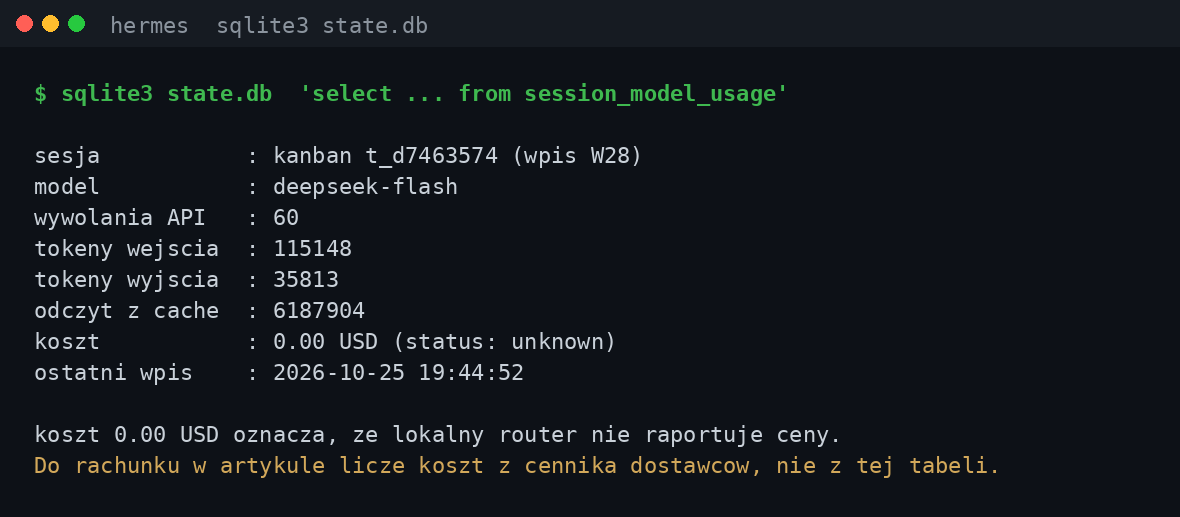
Zrzut zużycia z Hermesa pokazuje to wprost. Sesja, w której powstał ten wpis, zużyła 115 148 tokenów wejścia i 35 813 tokenów wyjścia przy 60 wywołaniach. Osobno widać 6 187 904 tokenów odczytanych z cache, czyli kontekst, który nie był przeliczany od zera.
Co wysyłasz: tekst, obraz i PDF
Wklejony tekst jest najtańszy i najbardziej przewidywalny. Dokument demonstracyjny ma 40 stron A4, 14 475 słów i 86 416 znaków, a tiktoken o200k_base liczy go na 34 035 tokenów. Ten sam tekst wyciągnięty z PDF-a warstwą tekstową daje 35 261 tokenów, o 1 226 więcej, czyli 3,6 procent, bo dochodzą nagłówki i stopki powtarzane na każdej stronie.
Obraz liczy się inaczej. Strona A4 wyrenderowana w 150 dpi ma 1241 na 1754 pikseli i według formuły z dokumentacji Anthropic to 2 835 tokenów. Czterdzieści stron jako obrazy to 113 400 tokenów, czyli 3,3 razy więcej niż ten sam tekst. Reguły OpenAI dla gpt-6-astra dają 2 574 tokenów na stronę i 102 960 tokenów na cały dokument.
Zdjęcie tabeli z danymi dokłada drugi koszt, czyli ryzyko odczytu. Mój test tego ryzyka nie potwierdził. Claude-haiku-5.5 i gemini-4-argon odczytały 8 z 8 wierszy poprawnie w czterech wariantach, od czystego renderu 150 dpi po miniaturkę 700 pikseli z kompresją JPEG. Ryzyko zostaje, bo dokumentacja OpenAI wprost ostrzega przed małym tekstem, obrotem zdjęcia i wykresami.
PDF wyciągam do tekstu, chyba że układ jest treścią. Rysunek, schemat instalacji albo zrzut interfejsu niosą informację, której opis słowny nie odtworzy. Wtedy wysyłam jedną stronę jako obraz, a nie czterdzieści.
Prompt napisany porządnie: system KARTKA
Dobry prompt zmniejsza liczbę powtórzeń, a każda powtórka to pełny koszt wejścia policzony od nowa. Używam systemu KARTKA, który ma sześć elementów: kontekst i odbiorca, akcja, rezultat, treść i źródła, kryteria i ograniczenia, autokontrola. Każdy element odpowiada na pytanie, które model zadałby bez niego.
Przykład z pracy. Zamiast „streść ten katalog” piszę, kto czyta streszczenie i w jakiej formie ma być wynik. Dopisuję, z których stron korzystać i co ma zrobić model, gdy w dokumencie nie ma danych. Prompt w KARTCE ma 200 do 400 tokenów, czyli około 1 procent dokumentu 40 stron.
Pełny opis sześciu elementów z przykładami przygotowuję w osobnym wpisie. Oszczędność nie bierze się z długości promptu, a z braku drugiej i trzeciej próby.
Caveman: telegraficzny styl oszczędza wyjście, nie wejście
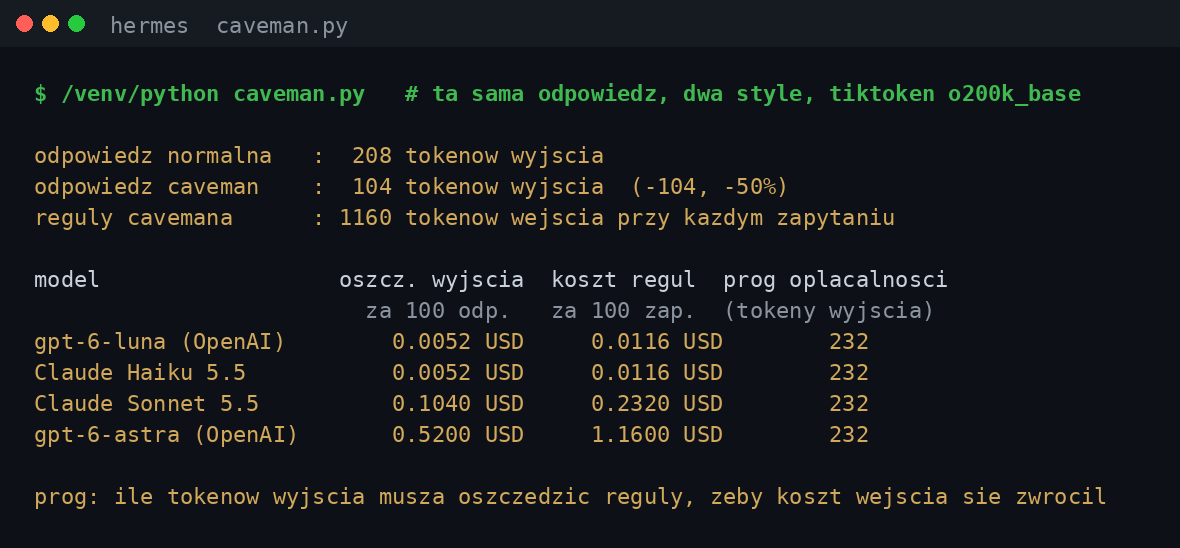
Caveman to styl, w którym model odpowiada telegraficznie: bez rodzajników, bez uprzejmości, bez zdań łączących. Zmierzyłem to na jednym zadaniu i jednej odpowiedzi. Wersja normalna miała 208 tokenów wyjścia, wersja caveman 104 tokeny, czyli połowę.
Oszczędność dotyczy wyjścia, nie wejścia: reguły, które każą modelowi mówić w ten sposób, zajmują 1 160 tokenów i jadą przy każdym zapytaniu. Przy gpt-6-luna oszczędność na stu odpowiedziach to 0,0052 USD, a koszt reguł na stu zapytaniach to 0,0116 USD. Reguły zwracają się dopiero wtedy, gdy jedna odpowiedź oszczędza ponad 232 tokeny wyjścia. Z promptem systemowym w cache próg spada do 23 tokenów.
Zastrzeżenie jest praktyczne. Przy treściach technicznych skrót gubi niuanse, bo „brak danych” i „nie sprawdziłem” brzmią w nim tak samo, a różnica decyduje o tym, czy wynik nadaje się do wysłania. Caveman zostawiam do krótkich i powtarzalnych odpowiedzi, nie do analizy dokumentacji.
Skąd biorę liczby o samym stylu: repozytorium projektu caveman na GitHubie (dostęp 2026-10-25) oraz test A/B opublikowany przez JetBrains w lipcu 2026 (dostęp 2026-10-25). Obie odpowiadały kodem 200.
Routing modeli: najtańszy model, który wykona zadanie
Routing modeli to wybór najtańszego modelu, który wykona zadanie, a nie najlepszego modelu, jaki masz pod ręką. Ten sam dokument 40 stron i 300 tokenów wyjścia kosztuje 0,0036 USD na gpt-6-luna. Na claude-sonnet-5.5 to 0,0711 USD, a na gpt-6-astra 0,3554 USD. Różnica między skrajnymi to prawie sto razy i nie wynika z jakości odpowiedzi, a z cennika.
Praktyka jest krótka: zadanie testowe na pięciu przykładach, na których znasz poprawny wynik. Jeśli tańszy model przechodzi, droższy nie ma czego szukać przy tym typie pracy. Jeśli nie przechodzi, płacisz za droższy model tylko przy tym zadaniu, a nie przy całym tygodniu.
Kiedy routing przestaje działać, opisałem w wpisie o routingu zadań i wyborze modelu (dostęp 2026-10-25). Osobno warto przeczytać tekst o pomiarze kosztu zadania, bo raport narzędzia bywa kosztorysem, a nie fakturą (dostęp 2026-10-25).
Nowa rozmowa, plik i skill zamiast wklejania procedury
Nowe zadanie zaczynam w nowej rozmowie. Stary wątek ciągnie za sobą historię, która przy każdym pytaniu wraca w całości, a do nowego zadania prawie nigdy nie wnosi nic. Jedna rozmowa to jedno zadanie, a nowy temat to nowy wątek.
Plik zamiast wklejania działa w dwie strony. Agent czyta plik z dysku, kiedy go potrzebuje, więc nie wklejam tych samych czterdziestu stron przy każdej poprawce. Wklejenie i tak trafia do kontekstu, różnica jest tylko w tym, ile razy.
Procedurę przenoszę do skilla, gdy powtarzam ją trzeci raz. Skill to plik, który model wczytuje na żądanie, więc opis procedury nie jedzie w każdym zapytaniu. Skala bywa duża: 1 160 tokenów reguł przy każdym zapytaniu kontra 40 tokenów zdania „użyj skilla od rachunku”.
Przykład liczbowy: dokument 40 stron w trzech wariantach
Zebrałem trzy warianty jednego zadania w jednej tabeli. Dokument ten sam, wyjście 300 tokenów w każdym wariancie, ceny sprawdzone 2026-10-25 w API OpenRouter oraz w cennikach OpenAI i Anthropic.
| Wariant | Tokeny wejścia | gpt-6-luna | claude-sonnet-5.5 | gpt-6-astra |
|---|---|---|---|---|
| Tekst wklejony | 34 035 | 0,0036 USD | 0,0711 USD | 0,3554 USD |
| Tekst z PDF | 35 261 | 0,0037 USD | 0,0735 USD | 0,3676 USD |
| 40 stron jako obrazy, formuła Anthropic | 113 400 | 0,0115 USD | 0,2298 USD | 1,1490 USD |
| 40 stron jako obrazy, reguły OpenAI | 102 960 | 0,0104 USD | 0,2089 USD | 1,0446 USD |
Jakość odpowiedzi różni się mniej niż cena. Tekst zachowuje liczby i podpisy tabel, a obraz dokłada ryzyko odczytu i nie pozwala wyszukać konkretnej frazy. PDF z warstwą tekstową jest blisko tekstu: 3,6 procent drożej i bez ryzyka odczytu.
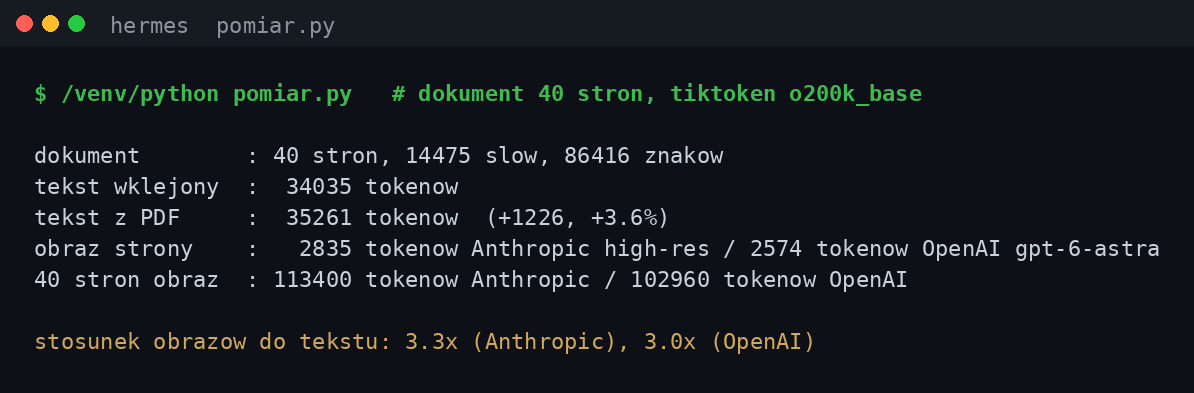
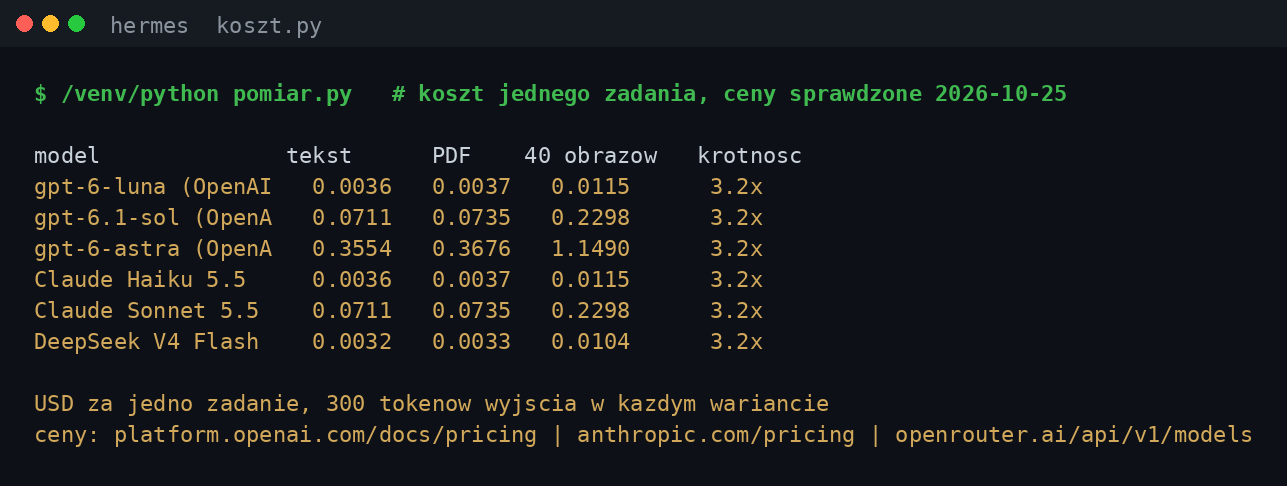
Przejście z obrazów na tekst zmniejsza koszt 3,3 razy i usuwa ryzyko odczytu. Wybór modelu zmienia koszt sto razy, ale nie zmienia sposobu pracy, więc robi się go raz.
Kiedy to nie zadziała
Skan bez warstwy tekstowej nie da się wyciągnąć do tekstu, więc zostaje OCR albo obraz. OCR to osobny koszt, liczony poza rachunkiem modelu, a jego wynik nadal wymaga sprawdzenia.
Strony, na których układ jest treścią, tracą przy konwersji. Rysunek, schemat instalacji, zrzut interfejsu i tabela ze scalonymi komórkami niosą informację w rozmieszczeniu, którego akapit nie odtworzy.
Plany rozliczane ryczałtem albo kredytami nie liczą tokenów wprost. W subskrypcji walutą jest limit i okno czasu, więc tabela kosztów z tego wpisu tłumaczy tylko mechanizm, a nie wysokość rachunku.
Checklista: dziesięć punktów na jutro
- Policz tokeny tego, co wysyłasz, zanim wybierzesz model: tiktoken albo licznik w narzędziu.
- Wklejaj tekst, nie zdjęcie tekstu, jeśli dokument ma warstwę tekstową.
- Wyciągnij PDF do tekstu i sprawdź, czy nie zgubił tabel.
- Wysyłaj obraz tylko dla stron, na których liczy się układ.
- Zaczynaj nowe zadanie w nowej rozmowie.
- Trzymaj dokumenty w pliku i podawaj ścieżkę, zamiast wklejać je po raz trzeci.
- Sprawdź, czy tańszy model przechodzi test na pięciu przykładach.
- Włącz caveman tylko do krótkich odpowiedzi, nie do analizy.
- Przenieś powtarzaną procedurę do skilla po trzecim powtórzeniu.
- Zapisz datę sprawdzenia cennika obok tabeli, bo ceny zmieniają się szybciej niż metody.
Zacznij od jednego punktu: weź zadanie z zeszłego tygodnia i policz, ile tokenów wejścia to ten sam kontekst wysłany drugi raz. Ta liczba mówi więcej niż cennik.
Jak powstał ten materiał
Pomiary wykonałem 25 października 2026 na dokumencie demonstracyjnym wygenerowanym na potrzeby wpisu: 40 stron A4, 14 475 słów, 86 416 znaków. Tokeny liczyłem biblioteką tiktoken z kodowaniem o200k_base (dostęp 2026-10-25), a tekst z PDF-a wyciągałem PyMuPDF (dostęp 2026-10-25).
Tokeny obrazów policzyłem z formuł opisanych w dokumentacji Anthropic i OpenAI (dostęp 2026-10-25). Ceny sprawdziłem w API OpenRouter oraz w cennikach OpenAI i Anthropic (dostęp 2026-10-25). Koszty są syntetyczne, policzone z cennika, a nie odczytane z faktury. Testu odczytu tabeli nie udało mi się odtworzyć: oba modele odczytały wszystkie wiersze, więc wpis opisuje ryzyko z dokumentacji, a nie zmierzony błąd.
Sprawdź również:
- Jak utrzymać model 3D w Revicie w dobrej kondycji?
- BCF w projekcie: od kolizji do zamknięcia uwagi
- IFC dla MEP: eksport z Revita bez bólu
- CDE w praktyce: RFI, submittals i akceptacje
- ISO 19650 po ludzku: nazewnictwo, statusy i metadane
Treść tego artykułu została stworzona z pomocą sztucznej inteligencji.