Darmowe modele AI: co daje LM Studio, co darmowe plany, a co agregatory. Limity sprawdzone 20.10.2026 i zadania, do których wystarczą.
Jeszcze kilka lat temu darmowy model oznaczał zabawkę, która po trzech zdaniach gubiła wątek. Dziś darmowe modele AI wystarczają do większości codziennych zadań, o ile zna się ich limity i nie wysyła się do nich tego, czego nie wolno. Różnica między darmowym modelem a subskrypcją to zwykle nie jakość odpowiedzi, a wiedza, gdzie kończy się limit.
Ten wpis to przegląd tego, co jest dziś dostępne bez płacenia: modele lokalne przez LM Studio, darmowe plany po rejestracji i okazje z agregatorów. Znajdziesz tu:
- podział darmowych modeli na trzy drogi, z kosztem każdej z nich,
- tabelę z limitami sprawdzonymi 20 października 2026,
- trzy zadania, które darmowy model robi dobrze,
- trzy zadania, których nie zrobi i nie ma sensu go do nich zmuszać,
- co zrobić z danymi, zanim wkleisz cokolwiek do darmowego planu,
- jaki układ wybrać na start, jeśli nie chcesz płacić.
Jedna uwaga na początku, bo bez niej reszta tekstu byłaby nieuczciwa. Limity darmowych planów zmieniają się co kilka tygodni: Google w grudniu 2025 obniżył część dziennych progów o ponad 80 procent, bez długiego ostrzeżenia. Wszystkie liczby sprawdziłem 20 października 2026 i traktuj je jako punkt wyjścia, nie umowę. Wiążąca jest zawsze tabela w panelu Twojego konta.
Trzy drogi do darmowego modelu
Darmowe modele nie są jedną kategorią. Są trzy drogi i każda kosztuje co innego: sprzęt, konto albo uwagę. Mylenie ich prowadzi do rozczarowania.
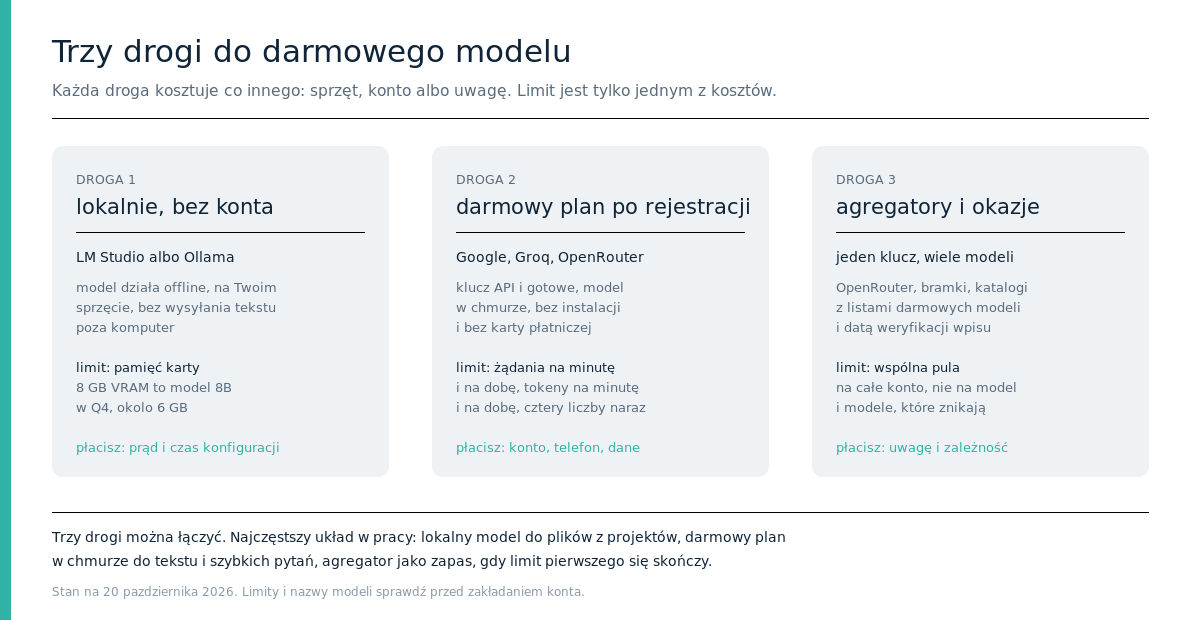
Droga pierwsza: lokalnie, bez konta. LM Studio albo Ollama, model w formacie GGUF na Twoim dysku, zero rejestracji. Model działa offline, więc tekst nie opuszcza komputera. Limit jest jeden i twardy: pamięć. Karta z 8 GB VRAM mieści model 8B w kwantyzacji Q4, czyli około 6 GB. Model 30B potrzebuje około 20 GB, model 70B około 42 GB. Jeśli model nie mieści się w karcie, część pracy przechodzi na procesor i generacja zwalnia z kilkudziesięciu tokenów na sekundę do kilku. O ustawieniach pisałem w wpisie LM Studio, optymalizacja lokalnych LLM, a instalację od zera pokazuje LM Studio, część 1.
Droga druga: darmowy plan po rejestracji. Zakładasz konto, generujesz klucz API i korzystasz z modelu w chmurze. Bez instalacji, bez karty płatniczej, ale z czterema limitami naraz: żądania na minutę, żądania na dobę, tokeny na minutę i tokeny na dobę. Do tego dochodzi cena, o której rzadko się mówi: konto, czasem weryfikacja telefonem i zgoda na to, że dane z darmowego planu mogą posłużyć do trenowania modelu. To nie jest ukryta opłata, to jest opłata.
Droga trzecia: agregatory i okazje. Jeden klucz do wielu modeli, katalogi zbierające darmowe plany i promocje typu „ten model jest darmowy do odwołania”. Zaleta jest oczywista: nie zakładasz pięciu kont, żeby sprawdzić pięć modeli. Koszt też: limit bywa wspólny dla całego konta, a model, na którym oparłeś pracę, może zniknąć z oferty w ciągu tygodnia. Dobra droga do testów i do zapasu, zła jako fundament.
Co jest darmowe 20 października 2026: tabela
Poniższa tabela to nie ranking i nie wyniki testów. To limity przepisane z dokumentacji dostawców i z paneli kont, z opisem zastosowania, bo ranking bez własnych testów byłby zgadywaniem w ładnej tabelce.
| Model lub dostawca | Dostęp | Limit (stan 20.10.2026) | Do czego się nadaje |
|---|---|---|---|
| LM Studio z modelem 4B do 8B | lokalnie, bez konta, offline | tylko pamięć karty, brak limitu zapytań | praca na plikach z projektów, notatki, PDF-y, dane, których nie wysyłasz |
| Google AI Studio, modele Flash i Flash-Lite | konto Google, bez karty | osobny limit dla każdego modelu, od kilkudziesięciu do kilkuset żądań na dobę, model Pro poza darmowym planem | długi kontekst, PDF-y, obrazy, ekstrakcja danych |
| Groq, na przykład gpt-oss-120b i qwen3.8-27b | konto i weryfikacja telefonem | 30 żądań na minutę, 1000 na dobę, 8000 tokenów na minutę, 200 000 tokenów na dobę, liczone na model | szybkie odpowiedzi, tekst, krótkie zadania, transkrypcja |
| OpenRouter, modele z końcówką :free | konto, bez karty | 20 żądań na minutę, 50 na dobę, a po jednorazowym zakupie kredytów za 10 dolarów 1000 na dobę | wiele modeli jednym kluczem, porównywanie odpowiedzi, zapas |
| Mistral, plan Experiment | konto, telefon i zgoda na trenowanie na danych | limity niepublikowane, sprawdzasz w konsoli | eksperymenty i prototypy, nie praca z danymi klienta |
| Cloudflare Workers AI | konto | 10 000 Neurons na dobę, reset o północy UTC | lekkie zadania, klasyfikacja, embeddingi |
| Katalogi i bramki, na przykład freeinference.dev, freetokens.fyi, promocje bramek kodowych | różnie, część bez konta | zmienne, często ograniczone czasowo | szukanie okazji i testów, nie podstawa codziennej pracy |
Limit żądań bywa wysoki, a limit tokenów niski, i liczy się on na dobę kalendarzową dostawcy, nie na Twoją dobę pracy.
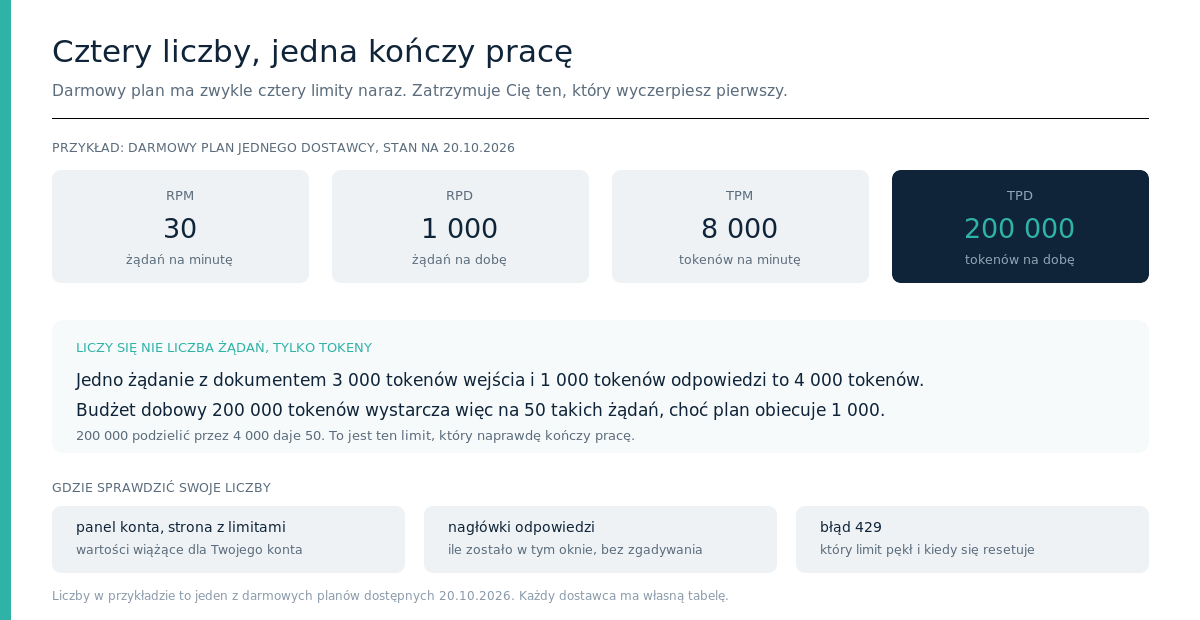
Przykład, który pokazuje, dlaczego sama liczba żądań na dobę myli. Darmowy plan jednego z dostawców daje 1000 żądań i 200 000 tokenów na dobę. Jedno żądanie z dokumentem to 3000 tokenów wejścia i 1000 odpowiedzi, razem 4000. Dzieląc 200 000 przez 4000 dostajesz 50 żądań, nie 1000. Trzy tysiące tokenów wejścia to około 2000 słów, czyli cztery strony A4. Krótkie zadania poczują limit żądań, wrzucanie dokumentów poczuje tokeny.
Trzy zadania, które darmowy model robi dobrze
Darmowy model sprawdza się tam, gdzie zadanie jest krótkie, sprawdzalne i nie wymaga pamięci o dziesięciu poprzednich krokach. Trzy przykłady z pracy projektowej.
1. Porządkowanie tekstu, który i tak masz w notatkach. Notatki ze spotkania koordynacyjnego, sześć stron chaotycznych punktów, w połowie powtórzenia. Model zamienia to na listę ustaleń, listę zadań z właścicielami i listę pytań otwartych. Lokalny model 8B robi to w kilkanaście sekund, bez wysyłania czegokolwiek poza komputer, a wynik sprawdzasz w dwie minuty. To zadanie ma niskie ryzyko: jeśli model coś pominie, zauważysz to przy czytaniu, bo znasz temat.
2. Wyciąganie danych z krótkich dokumentów. Tabela parametrów z PDF-a, spis urządzeń, zestawienie pomieszczeń z opisów. Model czyta fragment i zwraca wiersze w stałym formacie, gotowe do wklejenia w arkusz. Tutaj darmowy plan w chmurze ma przewagę nad lokalnym, bo modele Flash radzą sobie z PDF-ami i obrazami, a darmowy kontekst wystarcza na kilkadziesiąt stron. Lokalnie też się da, ale potrzebujesz modelu z wizją i 16 GB VRAM.
3. Szkice kodu i skryptów do powtarzalnych czynności. Funkcja w Pythonie do zmiany nazw rodzin, formuła w arkuszu, regex do wyciągnięcia numerów z nazw plików, szkielet skryptu pyRevit. Krótkie sesje, sprawdzalny wynik, natychmiastowa informacja zwrotna. Darmowy model nie napisze całego narzędzia, ale napisze trzydzieści linii, które potem poprawiasz. O szerszym zestawie takich zastosowań pisałem w wpisie AI dla inżyniera, ponad 40 praktycznych zastosowań.
Trzy zadania, których darmowy model nie zrobi
Granica nie przebiega tam, gdzie kończy się inteligencja modelu, tylko tam, gdzie kończy się limit albo zaczyna odpowiedzialność. Trzy sytuacje, w których darmowy model zawodzi przewidywalnie.
1. Długie zadania agentowe. Zadanie, w którym model ma wykonać trzydzieści kroków, wywołać narzędzia i sprawdzić wynik, zużywa jedno żądanie na krok, a często więcej. Przy 50 żądaniach na dobę w OpenRouter to jedna sesja i koniec dnia. Groq z tysiącem żądań wygląda lepiej, dopóki nie policzysz tokenów: pętla narzędziowa zjada 10 do 50 tysięcy tokenów na zadanie, a budżet dobowy to 200 tysięcy. Agent to zadanie dla płatnego planu, nie dlatego, że darmowy model jest głupszy, ale dlatego, że darmowy plan nie jest na to policzony.
2. Duży kontekst. Cała specyfikacja, komplet dokumentacji, sto stron warunków. Model lokalny ma kontekst ograniczony pamięcią, a nie obietnicą z cennika: na 8 GB VRAM realnie zostaje kilkanaście tysięcy tokenów, jeśli chcesz sensownej prędkości. W chmurze bywa lepiej, ale limit tokenów na minutę i tak zetnie długie wprowadzenie. Wrzucenie dwustu stron do darmowego planu kończy się albo błędem, albo odpowiedzią, która opiera się na pierwszych dwudziestu stronach, bo reszta wypadła z kontekstu. To najczęstszy cichy błąd: nie ma komunikatu, jest tylko gorsza odpowiedź.
3. Dane, których nie wolno wysłać. Umowa z klientem, dane osobowe, nazwy projektów, rzuty, harmonogram z nazwiskami. Darmowe plany w chmurze często zastrzegają, że dane mogą posłużyć do trenowania modelu, a część wymaga do tego tylko akceptacji regulaminu przy rejestracji. Wysłanie tam dokumentacji projektu to nie kwestia wygody, to decyzja o przekazaniu danych podmiotowi trzeciemu, często poza Unią Europejską. Jeśli dane są wrażliwe, darmowa droga jest jedna: model lokalny.
Osobna sprawa, bo to limit modelu, nie planu: obliczenia i normy. Darmowy model 8B nie jest kalkulatorem i nie może być jedynym źródłem liczby, która idzie do projektu.
Bezpieczeństwo danych na darmowych planach
To najważniejsza sekcja tego wpisu i najczęściej pomijana w tekstach o darmowych modelach. Darmowość ma warunek, a warunek jest zapisany w regulaminie, nie w interfejsie. Pięć rzeczy do sprawdzenia, zanim wkleisz pierwszy dokument.
- Czy plan trenuje na danych. Google w darmowym planie może używać promptów i odpowiedzi do ulepszania modeli, poza Wielką Brytanią, Szwajcarią i EOG. Mistral w planie Experiment również. Groq deklaruje, że nie trenuje na danych z API. OpenRouter sam tego nie robi, ale model może być serwowany przez dostawcę, który robi, i jest ustawienie konta, które takich dostawców wyklucza.
- Co dokładnie wysyłasz. Zanim wyślesz dokument, zamień nazwy: klient na „Klient A”, projekt na „Projekt 1”, adresy na „Adres X”. To minimum, które pozwala korzystać z darmowego planu bez przekazywania danych identyfikujących.
- Czy w ustawieniach jest przełącznik trenowania. Jeśli jest, wyłącz go i zapisz sobie, gdzie leży. Część dostawców ma go osobno dla darmowych modeli, osobno dla płatnych.
- Jak długo trzymane są logi. Nawet dostawca, który nie trenuje, może przechowywać żądania przez 30 dni na potrzeby nadużyć. Sprawdzenie polityki retencji zajmuje dwie minuty i zmienia odpowiedź na pytanie, czy wolno wysłać umowę.
- Gdzie działa Twój klient. Regulamin Google pozwala serwować API klientom końcowym w EOG, Szwajcarii i Wielkiej Brytanii tylko w planie płatnym. Własne użycie w darmowym planie nadal działa, ale przy narzędziu dla kogoś sprawdź to przed wdrożeniem.
Praktyczna reguła, którą stosuję u siebie: pliki z projektów nie opuszczają komputera, teksty i pytania ogólne mogą iść do darmowego planu, a wszystko, co ma nazwę klienta, idzie do modelu lokalnego albo do płatnego planu z wyłączonym trenowaniem. W biurze, w którym dane klientów podlegają umowie o poufności, ustal tę regułę razem z osobą odpowiedzialną za RODO.
Co wybrać na start
Trzy warianty, zależnie od tego, co masz pod biurkiem i co robisz najczęściej. Każdy działa bez płacenia.
- Masz kartę z 8 GB VRAM i pracujesz na plikach z projektów. LM Studio i jeden model 8B w Q4, na przykład Qwen albo Llama w wersji instrukcyjnej. To domyślny model do notatek, PDF-ów i wszystkiego, czego nie wolno wysłać.
- Masz słabszy laptop i pracujesz głównie na tekście. Groq po rejestracji z weryfikacją telefonem, model gpt-oss-120b. Szybko, bez karty, z limitem, który wystarcza na pisanie i poprawianie tekstów. Do dłuższych dokumentów dołóż Google AI Studio, bo darmowy kontekst jest tam największy.
- Chcesz sprawdzić kilka modeli bez zakładania kont. OpenRouter z modelami :free albo katalog w rodzaju freeinference.dev. Traktuj to jako listę kandydatów, nie jako miejsce, w którym zostaniesz.
Plan na pierwszy tydzień, jeśli chcesz mieć pewność, że darmowa droga wystarcza:
- Zapisz trzy zadania, które robisz co tydzień, i oszacuj, ile tokenów zużywa każde. To jedyna liczba, która naprawdę decyduje o wyborze planu.
- Uruchom jedno z nich lokalnie, a drugie na darmowym planie. Porównaj nie jakość ogólną, a liczbę poprawek, które musisz wprowadzić.
- Policz, ile razy w tygodniu trafisz na limit. Jeśli rzadziej niż raz, darmowy plan jest wystarczający.
- Ustal regułę danych i zapisz ją w jednym miejscu, żeby nie decydować o niej przy każdym wklejeniu.
Darmowe modele nie są gorszą wersją płatnych. Są innym narzędziem z innym cennikiem: płacisz pamięcią, uwagą albo danymi. Kto zna te trzy waluty, ten przez większość tygodnia nie potrzebuje subskrypcji.
Ten wpis jest częścią serii o pracy z wieloma modelami. W kolejnych częściach opowiem o routingu zadań i o pomiarze kosztu pojedynczego zadania. Jeśli chcesz zacząć od podstaw lokalnych modeli, zajrzyj do pierwszej części o LM Studio i do wpisu o lokalnym modelu w Obsidianie.
Sprawdź również:
- ISO 19650 po ludzku: nazewnictwo, statusy i metadane
- IFC dla MEP: eksport z Revita bez bólu
- Darmowe modele AI: co wystarcza, a co nie
- Jak przenieść PDF, Word i Excel do Obsidiana?
- 10 darmowych alternatyw open-source, które zastąpią Twoje drogie subskrypcje
Treść tego artykułu została stworzona z pomocą sztucznej inteligencji.