W biurze projektowym wiedza rzadko ginie spektakularnie. Ginie po cichu: w mailu z 2023 roku, w PDF-ie na dysku sieciowym, w głowie osoby, która właśnie złożyła wypowiedzenie. Kiedy po roku ktoś pyta, jak rozwiązaliśmy odwodnienie garażu w poprzednim projekcie, nikt nie potrafi odpowiedzieć w mniej niż pół dnia. Model językowy mógłby odpowiadać na takie pytania,…
W biurze projektowym wiedza rzadko ginie spektakularnie. Ginie po cichu: w mailu z 2023 roku, w PDF-ie na dysku sieciowym, w głowie osoby, która właśnie złożyła wypowiedzenie. Kiedy po roku ktoś pyta, jak rozwiązaliśmy odwodnienie garażu w poprzednim projekcie, nikt nie potrafi odpowiedzieć w mniej niż pół dnia.
Model językowy mógłby odpowiadać na takie pytania, ale żeby robił to sensownie, musi mieć dostęp do twoich dokumentów. Nie chodzi o wysłanie ich do chmury, tylko o lokalny układ trzech warstw: dokumenty, notatki, model. Całość mieści się na jednym komputerze w biurze i nie wymaga serwera ani abonamentu.
W tym wpisie pokażę:
- dlaczego wyszukiwanie w Windows i w skrzynce mailowej nie wystarcza,
- jak zbudować trzy warstwy: Paperless, Obsidian i LM Studio,
- jak wygląda przepływ od skanu do odpowiedzi z cytatem,
- ile to kosztuje, jeśli komputer już masz,
- jak wdrożyć to w jeden dzień i na czym ludzie się wykładają.
Ten wpis jest trzecią częścią układanki. Dwie pierwsze opisują samą bazę notatek: jak zbudować bazę wiedzy w Obsidianie pod Claude Code i Codex oraz jak połączyć Codex z Obsidianem. Jeśli ich nie znasz, zajrzyj tam najpierw, bo tutaj zakładam, że wiesz, czym jest vault, frontmatter i linkowanie notatek.
Problem: wiedza leży w mailach, PDF-ach i głowach
W biurze, w którym pracuję, jeden przeciętny projekt to około 300 do 400 dokumentów. Opisy techniczne, rysunki, protokoły narad, korespondencja z wykonawcą, wytyczne inwestora, decyzje administracyjne. Po pięciu latach działalności taka baza ma kilkanaście tysięcy plików, a wyszukiwanie w Windows nadal działa po nazwie pliku, nie po treści. PDF ze skanu nie ma warstwy tekstowej, więc nie znajdziesz w nim nic, dopóki ktoś nie zrobi OCR.
Tylko że prawdziwy problem nie polega na tym, że nie możesz znaleźć pliku. Problem polega na tym, że nie możesz znaleźć wniosku. Nie szukasz „wentylacja hala.dwg”, tylko odpowiedzi na pytanie: czy przy takiej wysokości wody gruntowej stosowaliśmy studzienki liniowe i czy to się sprawdziło. Plik jest gdzieś na dysku od trzech lat, ale wiedza, która z niego wynikała, została w głowie projektanta.
Druga rzecz: wiedza wychodzi drzwiami razem z ludźmi. Osoba z piętnastoletnim doświadczeniem zabiera ze sobą nie pliki, te przecież zostają w firmie, tylko sposób myślenia o nich. Nowy pracownik dostaje folder z tysiącami PDF-ów i zero kontekstu.
Model językowy sam tego nie naprawi. Bez dostępu do twoich materiałów odpowiada na podstawie tego, co przeczytał w internecie: ogólnie, pewnym tonem i często niepoprawnie w szczegółach, które akurat mają znaczenie. Żeby odpowiadał konkretnie, potrzebuje trzech rzeczy naraz: dokumentów, notatek z wnioskami i modelu, który działa lokalnie.
Trzy warstwy i jeden komputer
Architektura, którą stosuję, ma trzy warstwy i jednego łącznika. Każda warstwa ma inne zadanie i inne tempo zmian, dlatego trzymam je osobno, zamiast wrzucać wszystko do jednego worka.
Warstwa 1: dokumenty w Paperless
Paperless-ngx działa w Dockerze i zajmuje się tym, co przychodzi z zewnątrz: PDF-ami, skanami, fakturami, pismami, korespondencją. Dokument wrzucony do folderu konsumpcji dostaje numer, datę, rozpoznanego kontrahenta i tagi nadane przez reguły. Paperless robi OCR, czyli wyciąga tekst ze skanu, i udostępnia wyszukiwanie pełnotekstowe oraz API. Oryginał zostaje w niezmienionej formie, nie jest konwertowany ani przepisywany.
Ważne zastrzeżenie: to nie jest CDE i nie udaje CDE. Nie ma tu rewizji, statusów, transmittali ani przepływu zatwierdzeń. Paperless służy do trzymania dokumentów i znajdowania ich po treści, a nie do prowadzenia wymiany informacji w projekcie. Jeśli potrzebujesz obiegu dokumentów zgodnego z ISO 19650, to osobny temat i osobne narzędzie.
Warstwa 2: notatki w Obsidianie
Druga warstwa to miejsce, w którym zapisujesz to, czego nie ma w żadnym PDF-ie: dlaczego wybraliśmy wariant B, co poszło nie tak przy koordynacji, jaką uwagę miał koordynator i czy po dwóch miesiącach okazała się słuszna. Obsidian trzyma notatki jako pliki Markdown, więc są czytelne bez aplikacji i przeżyją każdą zmianę oprogramowania.
Jak przenieść dokumenty do Obsidiana, pokazuję w filmie:
Zasada, która trzyma tę warstwę w kupie: notatka nie kopiuje dokumentu, tylko linkuje do niego i dopisuje wniosek. Dwa, trzy zdania wystarczą. Jeśli notatka jest dłuższa niż dokument, do którego się odwołuje, to znaczy, że ktoś przepisał PDF zamiast pomyśleć. Strukturę vaulta i konwencję frontmatter opisałem w wpisie o bazie wiedzy pod Claude Code i Codex, więc nie będę tego powtarzał.
Warstwa 3: model w LM Studio
LM Studio uruchamia model językowy na twoim komputerze i wystawia go jako serwer zgodny z API OpenAI. To jest cała magia: skoro API wygląda jak API OpenAI, to każdy klient, który umie gadać z OpenAI, umie też gadać z twoim modelem. Potrzebne są dwa modele. Jeden do rozmowy, najlepiej coś w rozmiarze 8 miliardów parametrów w kwantyzacji Q4. Drugi, mały, do zamiany tekstu na wektory, czyli do wyszukiwania po znaczeniu.
Jak uruchomić lokalny model do notatek, pokazuję w filmie:
Jeśli chcesz wycisnąć z lokalnego modelu więcej, mam osobny wpis o optymalizacji LM Studio. Przy bazie wiedzy większy wpływ na jakość odpowiedzi ma jednak porządek w dokumentach niż parametry próbkowania.
Łącznik: agent
Agent to program, który wykonuje polecenia w twoim imieniu: czyta pliki z folderu notatek, woła API Paperless, wysyła pytanie do modelu, składa odpowiedź i dopisuje źródła. Ręcznie robiłbyś dokładnie to samo, tylko w trzech oknach i z ciągłym kopiowaniem tekstu. Agent robi to w jednym przebiegu i, co ważniejsze, robi to samo za każdym razem.
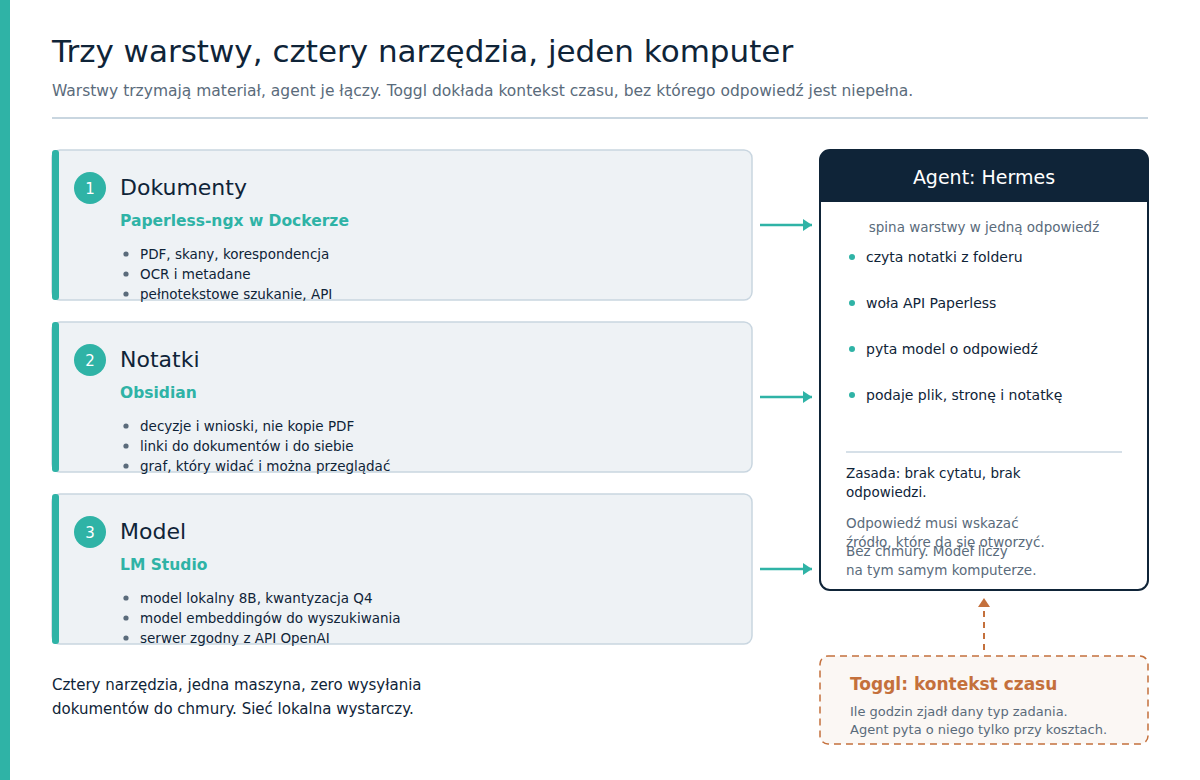
Na grafice jest jeszcze Toggl i warto wyjaśnić, dlaczego. Toggl nie jest warstwą wiedzy, jest warstwą kontekstu. Godziny z Toggl odpowiadają na pytanie, którego żaden dokument nie rozstrzygnie: czy to rozwiązanie było warte swojej ceny. Bez tego agent potrafi powiedzieć, jak rozwiązaliśmy problem, ale nie potrafi powiedzieć, czy drugi raz zrobilibyśmy tak samo.
Przepływ: od skanu do odpowiedzi z cytatem
Cały układ ma jeden przepływ i sześć kroków. Każdy z nich robi coś, czego nie da się przeskoczyć.
- Dokument trafia do folderu konsumpcji. PDF z maila, skan umowy, protokół z narady. Nikt nie musi nic wpisywać ręcznie.
- Paperless robi OCR i wyciąga metadane. Tekst ze skanu, data, kontrahent, typ dokumentu, tagi nadane przez reguły.
- Dokument dostaje numer i adres. Od tej chwili jest linkowalny, także z notatki w Obsidianie i z odpowiedzi modelu.
- Notatka zapisuje wniosek, nie treść. Link do dokumentu i dwa zdania: co z tego wynika dla następnego projektu.
- Agent szuka w dwóch miejscach naraz. Pełnotekstowo w Paperless, po znaczeniu w notatkach, a przy pytaniach o koszt dodatkowo w Toggl.
- Odpowiedź wraca z cytatem. Nazwa pliku, numer strony, nazwa notatki. Brak cytatu oznacza brak odpowiedzi.
Ostatni punkt jest całym sensem tego układu. Model w rozmiarze 8B myli się w liczbach i robi to z pełnym przekonaniem. Potrafi przepisać 160 mm jako 180 mm, bo tak mu wychodzi z kontekstu. Cytat zamienia taką odpowiedź w coś, co można sprawdzić w dwadzieścia sekund, i od razu pokazuje, czy model czytał właściwy dokument, czy tylko podobnie brzmiący.
Dlatego w instrukcji dla agenta mam twardą regułę: jeśli nie znajduje fragmentu źródłowego, ma powiedzieć, że nie wie, i wskazać, gdzie szukał. Odpowiedź „nie znalazłem, ale sprawdź notatkę o koordynacji z marca” jest dużo więcej warta niż pewna siebie synteza z niczego.
Przykład: precedens z innego projektu
Pytanie brzmiało mniej więcej tak: jak rozwiązaliśmy odwodnienie posadzki w garażu podziemnym, kiedy woda gruntowa była około metra pod posadzką, i ile nas to kosztowało w godzinach. Dokładnie ten typ pytania, na który zwykłe wyszukiwanie nie odpowiada, bo w plikach nie ma słowa „precedens”, a w notatkach nie ma słowa „odwodnienie” w tytule.
Agent zrobił cztery rzeczy. Przeszukał notatki po tagach związanych z garażem i wodą gruntową i znalazł trzy notatki. W Paperless znalazł dwa dokumenty z opisem technicznym, o długości 14 i 22 strony. W notatce z 2024 roku trafił na wniosek: studzienki liniowe, spadek posadzki pół procenta, rezygnacja z pompowni po konsultacji z geologiem. Na koniec sprawdził w Toggl, że etap zajął dwanaście godzin projektowania i cztery godziny poprawek po uwagach.
Czas odpowiedzi: cztery minuty, razem z otwarciem dwóch dokumentów i sprawdzeniem strony, na której jest detal. Wcześniej wyglądało to tak: telefon do kolegi, który pamiętał, że „coś takiego było”, przeszukanie dysku, otwarcie trzech PDF-ów i czytanie od środka. Pół dnia, jeśli kolega był na budowie, a projekt trzeba było oddać w piątek.
Liczby zaokrągliłem, nazw projektów nie podaję, bo to materiał z realnej pracy. Ważniejszy od detali jest kształt odpowiedzi: przyszła z trzema odnośnikami, które dało się otworzyć, i z jawnym wskazaniem, która notatka jest starsza i może być nieaktualna.
Efekt uboczny, którego się nie spodziewałem: przy tym pytaniu wyszło, że dwie notatki podają różne spadki dla podobnego rozwiązania. Nikt tego wcześniej nie zauważył, bo nikt nie czytał ich obok siebie.
Sprzęt i koszt: co wystarczy na start
Zaczynam od rzeczy, która najbardziej uspokaja: nie potrzebujesz serwera. Potrzebujesz jednego komputera, który stoi w biurze i nie jest wyłączany na noc. Model 8B w kwantyzacji Q4 zajmuje około 5 GB pamięci, razem z kontekstem ośmiu tysięcy tokenów około 6 do 7 GB. Zmieści się na karcie graficznej z 8 GB pamięci. Bez karty też pójdzie, na procesorze, tylko odpowiedź potrwa 30 do 60 sekund zamiast kilku.
| Pozycja | Wariant minimalny | Wariant z kartą graficzną |
|---|---|---|
| Komputer | ten, który już masz | ten sam |
| Pamięć RAM 32 GB | 250 do 400 zł | 250 do 400 zł |
| Dysk SSD 2 TB | 400 do 600 zł | 400 do 600 zł |
| Karta graficzna 8 do 12 GB | 0 zł | 1200 do 2000 zł |
| Paperless, Docker, LM Studio, agent | 0 zł | 0 zł |
| Licencja komercyjna Obsidiana | 0 zł, od 2025 dobrowolna | 0 zł |
| Razem | 0 do 1000 zł | 1500 do 3000 zł |
Ceny są orientacyjne i dotyczą raczej rynku wtórnego niż sklepu z nowym sprzętem. Paperless-ngx jest darmowy, Docker Desktop w małej firmie też nie generuje kosztu, LM Studio jest darmowe do użytku indywidualnego, także w pracy. Obsidian od 2025 roku nie wymaga już płatnej licencji komercyjnej, ale jeśli firma chce wspierać projekt, licencja kosztuje 50 dolarów za osobę na rok i nadal jest tańsza niż jedno spotkanie zespołu.
Czego nie kupować: serwera z dwiema kartami graficznymi. W biurze od 3 do 15 osób zapytań jest kilka dziennie, nie tysiące na minutę. Jeden desktop z kartą za półtora tysiąca złotych obsłuży cały zespół, jeśli odpowiada w kilka sekund. Sprzęt kupuje się wtedy, gdy kolejka zapytań zaczyna przeszkadzać, a nie na zapas.
Jest jeszcze koszt, o którym się nie mówi: czas ludzi. Ktoś musi wrzucać dokumenty i pisać notatki, inaczej baza nie zrobi się sama, niezależnie od tego, ile wydasz na komputer.
Wdrożenie krok po kroku w jeden dzień
To nie jest projekt na kwartał. Przy jednej osobie i bez programowania realny jest jeden dzień roboczy, sześć godzin z przerwą na obiad. Kolejność ma znaczenie: najpierw dokumenty, potem notatki, na końcu model. Odwrotna kolejność kończy się tym, że model jest gotowy, a nie ma na czym pracować.
Godzina 1: Docker i Paperless
Instalacja Dockera i uruchomienie Paperless z gotowego pliku compose. Konto administratora, jedna grupa dla zespołu, folder konsumpcji. Na tym etapie nie dotykasz uprawnień, tylko sprawdzasz, czy pierwszy PDF przechodzi przez OCR i czy wyszukiwanie znajduje w nim słowo z treści.
Godzina 2: import pierwszego projektu
Wrzucasz dokumenty jednego, dobrze znanego projektu. Nie wszystkich, nie całego archiwum. Chodzi o to, żeby mieć materiał, na którym znasz prawidłową odpowiedź i możesz sprawdzić, czy system jej nie przekłamuje. Ustawiasz kilka reguł tagowania po nazwie kontrahenta i typie dokumentu, resztę zostawiasz na później.
Godzina 3: Obsidian i szablon notatki
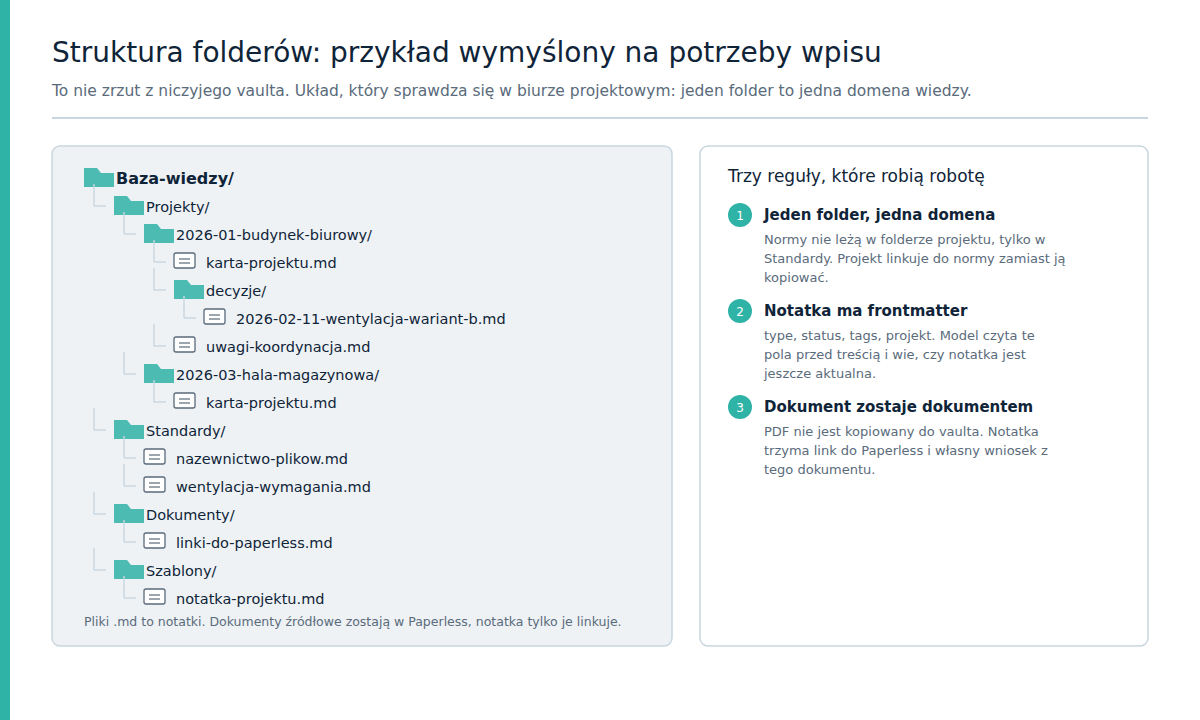
Pięć folderów, jeden szablon notatki projektu i frontmatter z czterema polami: type, status, tags, projekt. Do tego miejsce na link do Paperless. To wszystko. Struktura nie musi być idealna, musi być przewidywalna, bo model czyta ją jak instrukcję obsługi.
Godzina 4: LM Studio
Pobranie modelu do rozmowy i modelu do embeddingów, uruchomienie serwera lokalnego, test z poziomu terminala. Jeśli masz kartę graficzną, upewnij się, że model faktycznie liczy na karcie, a nie na procesorze. Jeśli nie masz, zmniejsz kontekst i nie oczekuj cudów.
Godzina 5: agent i trzy pytania testowe
Instrukcja dla agenta: gdzie leżą notatki, jak wołać API Paperless, jak formatować odpowiedź ze źródłami. Potem trzy pytania, na które znasz odpowiedź. Jedno łatwe, jedno podchwytliwe, jedno takie, na które odpowiedzi nie ma. Trzecie jest najważniejsze, bo pokazuje, czy agent potrafi przyznać się do niewiedzy.
Godzina 6: pierwsze dziesięć notatek
Dziesięć notatek z wnioskami z projektów, które zespół pamięta. To one zamieniają archiwum plików w bazę wiedzy, bo dodają warstwę „dlaczego”. Bez nich zostaje ci drogi czytnik PDF-ów.
Czego nie robić i gdzie ludzie się wykładają
Wszystkie punkty poniżej widziałem w praktyce, u siebie albo u znajomych z innych biur. Żaden nie wynika z ograniczeń oprogramowania, wszystkie z decyzji podjętych za szybko.
- Nie wrzucaj rysunków technicznych. PDF z rzutem to zwykle grafika bez warstwy tekstowej. Paperless go przyjmie, ale OCR zwróci bełkot, a model na podstawie bełkotu wymyśli opis. Dokumenty tekstowe tak, rysunki zostaw poza systemem.
- Nie ufaj liczbom bez cytatu. Model przepisze 160 mm jako 180 mm i nie mrugnie. Każda liczba w odpowiedzi musi mieć odnośnik do strony w dokumencie, a ty musisz mieć nawyk jej sprawdzania, przynajmniej przy pierwszych pięćdziesięciu odpowiedziach.
- Nie buduj bazy bez właściciela. Potrzebna jest jedna osoba z dwiema godzinami tygodniowo na porządkowanie tagów i domykanie notatek. Bez tego po trzech miesiącach baza jest zbiorem plików, których nikt nie linkuje.
- Nie zostawiaj domyślnych uprawnień. Paperless ma uprawnienia na poziomie dokumentu, ale dokumenty wrzucone do folderu konsumpcji nie mają właściciela, więc widzi je każdy. Zanim trafią tam umowy i oferty, ustaw workflows i grupy.
- Nie wystawiaj tego na świat. Sieć lokalna wystarczy. Jeśli ktoś pracuje zdalnie, VPN, a nie przekierowanie portu na routerze.
- Nie licz na to, że to zastąpi CDE. Brak rewizji, statusów i transmittali to nie brak funkcji, to inny rodzaj narzędzia. Baza wiedzy jest obok obiegu dokumentów, nie zamiast niego.
- Nie zapomnij o kopii zapasowej. Baza danych, folder z dokumentami i vault. Trzy kopie, jedna poza biurem. Najczęstsza awaria to nie atak, tylko dysk, który ma sześć lat.
Wnioski dla biura od 3 do 15 osób
Trzy efekty widać najszybciej. Pierwszy to czas szukania precedensu: z pół godziny do kilku minut, przy kilku takich pytaniach w tygodniu. Drugi to mniej powtórzonych błędów, bo wniosek z poprzedniego projektu przestaje być prywatną pamięcią jednej osoby. Trzeci, najtrudniejszy do zmierzenia: wiedza zostaje w firmie, kiedy ktoś odchodzi, przynajmniej ta część, którą zdążył zapisać.
Kiedy to się nie opłaci? Wtedy, gdy nikt w biurze nie ma zwyczaju zapisywania wniosków i nie chce mieć. Wtedy, gdy projekty są całkowicie różne i żaden nie powtarza rozwiązań z poprzedniego. I wtedy, gdy nie ma osoby, która przez pierwsze dwa miesiące dopilnuje porządku, bo bez niej projekt umiera po trzech tygodniach i zostaje po nim folder z Dockerem.
Od czego zacząć w tym tygodniu: wybierz jeden projekt, jedno pytanie, na które odpowiedź znasz, i jedno miejsce na notatki. Wrzuć dokumenty tego projektu do Paperless, napisz pięć notatek z wnioskami, sprawdź, czy agent odpowiada z cytatem. Jeśli tak, masz działający prototyp w jedno popołudnie i możesz decydować o reszcie na podstawie własnego materiału, a nie mojego wpisu.
Jeśli chcesz zacząć od mniejszego kroku, wróć do wpisu o bazie wiedzy w Obsidianie pod Claude Code i Codex i do wpisu o połączeniu Codex z Obsidianem. Ten tekst dokłada do nich dwie warstwy, bez których baza notatek zostaje zbiorem ładnych, ale martwych plików, a dokumenty w firmie nadal są tylko archiwum.
Sprawdź również:
- Jak utrzymać model 3D w Revicie w dobrej kondycji?
- BCF w projekcie: od kolizji do zamknięcia uwagi
- IFC dla MEP: eksport z Revita bez bólu
- CDE w praktyce: RFI, submittals i akceptacje
- ISO 19650 po ludzku: nazewnictwo, statusy i metadane
Treść tego artykułu została stworzona z pomocą sztucznej inteligencji.