Masz w Obsidianie bazę wiedzy: notatki z projektów, wyciągi z norm, wytyczne, transkrypcje spotkań i własne wnioski. Wyszukiwanie pełnotekstowe działa dobrze, dopóki wiesz, czego szukasz. Problem pojawia się wtedy, gdy pytanie nie brzmi jak fraza z notatki, tylko jak pytanie do drugiej osoby: czego wymagałem od wykonawcy przy wentylacji w ostatnim projekcie i dlaczego akurat…
Masz w Obsidianie bazę wiedzy: notatki z projektów, wyciągi z norm, wytyczne, transkrypcje spotkań i własne wnioski. Wyszukiwanie pełnotekstowe działa dobrze, dopóki wiesz, czego szukasz. Problem pojawia się wtedy, gdy pytanie nie brzmi jak fraza z notatki, tylko jak pytanie do drugiej osoby: czego wymagałem od wykonawcy przy wentylacji w ostatnim projekcie i dlaczego akurat tego.
Wtedy wyszukiwanie zwraca notatki, w których występuje słowo „wentylacja”, a nie odpowiedź na pytanie. Rozwiązanie nazywa się RAG (retrieval augmented generation): najpierw szukamy fragmentów po znaczeniu, a potem model językowy układa z nich odpowiedź i pokazuje, z których notatek ją wziął. Cały potok można postawić lokalnie, bez wysyłania notatek do chmury.
W tym wpisie pokażę:
- czym różni się wyszukiwanie pełnotekstowe od wyszukiwania po znaczeniu,
- jak działa potok RAG: podział notatek, embeddingi, indeks, pobranie kontekstu, odpowiedź,
- co przygotować w vaulcie, żeby wyniki były sensowne,
- trzy drogi wdrożenia: plugin Copilot z lokalnym modelem, Smart Connections i własny skrypt,
- typowe błędy, które psują odpowiedzi, i jak je rozpoznać.
Zakładam, że masz już uporządkowany vault. Jeśli dopiero go budujesz, zacznij od wpisu o bazie wiedzy w Obsidianie pod Claude Code i Codex, bo struktura folderów i frontmatter są dokładnie tym, na czym potem pracuje wyszukiwanie po znaczeniu.
Czym różni się wyszukiwanie pełnotekstowe od RAG
Wyszukiwanie pełnotekstowe porównuje znaki. Szuka notatek, w których występuje dokładnie ten wyraz albo jego forma. Działa szybko i jest przewidywalne, dlatego w Obsidianie korzystam z niego codziennie. Ma jednak jedną wadę: nie wie, że „wykonawca zgłosił kolizję” i „generalny wykonawca przesłał uwagę do koordynacji” to opisy tej samej sytuacji.
Wyszukiwanie po znaczeniu zamienia tekst na wektory, czyli ciągi liczb opisujące sens fragmentu. Notatka o kolizji kanałów i notatka o uwadze koordynacyjnej trafiają wtedy blisko siebie, mimo że nie mają wspólnych słów. Model językowy dostaje kilka najlepiej dopasowanych fragmentów i odpowiada na pytanie na ich podstawie. To jest cała idea RAG.
To nie oznacza, że wyszukiwanie pełnotekstowe przestaje być potrzebne. Gdy szukasz konkretnego numeru normy, nazwy pliku albo fragmentu, który pamiętasz, zwykłe wyszukiwanie jest szybsze i dokładniejsze. RAG wchodzi do gry dopiero wtedy, gdy pytanie jest opisowe i rozciąga się na kilka notatek.
Jak działa RAG: pięć elementów potoku
Cały mechanizm jest prostszy, niż się wydaje, i składa się z pięciu kroków. Warto je znać, bo każdy z nich psuje wynik na swój sposób.
- Podział notatek na fragmenty. Notatka jest dzielona na kawałki, najczęściej po nagłówkach albo po zadanej liczbie znaków. Od tego kroku zależy najwięcej: za duży fragment rozmywa odpowiedź, za mały gubi kontekst.
- Embeddingi. Każdy fragment trafia do modelu embeddingowego i wychodzi z niego wektor. Ten model to zwykle osobny, mały model, nie ten sam, który potem pisze odpowiedź.
- Indeks. Wektory lądują w pliku lub bazie wektorowej. To zwykła warstwa techniczna, którą można trzymać lokalnie obok vaulta.
- Pobranie kontekstu. Pytanie też jest zamieniane na wektor i porównywane z indeksem. Wraca kilka albo kilkanaście najlepiej dopasowanych fragmentów.
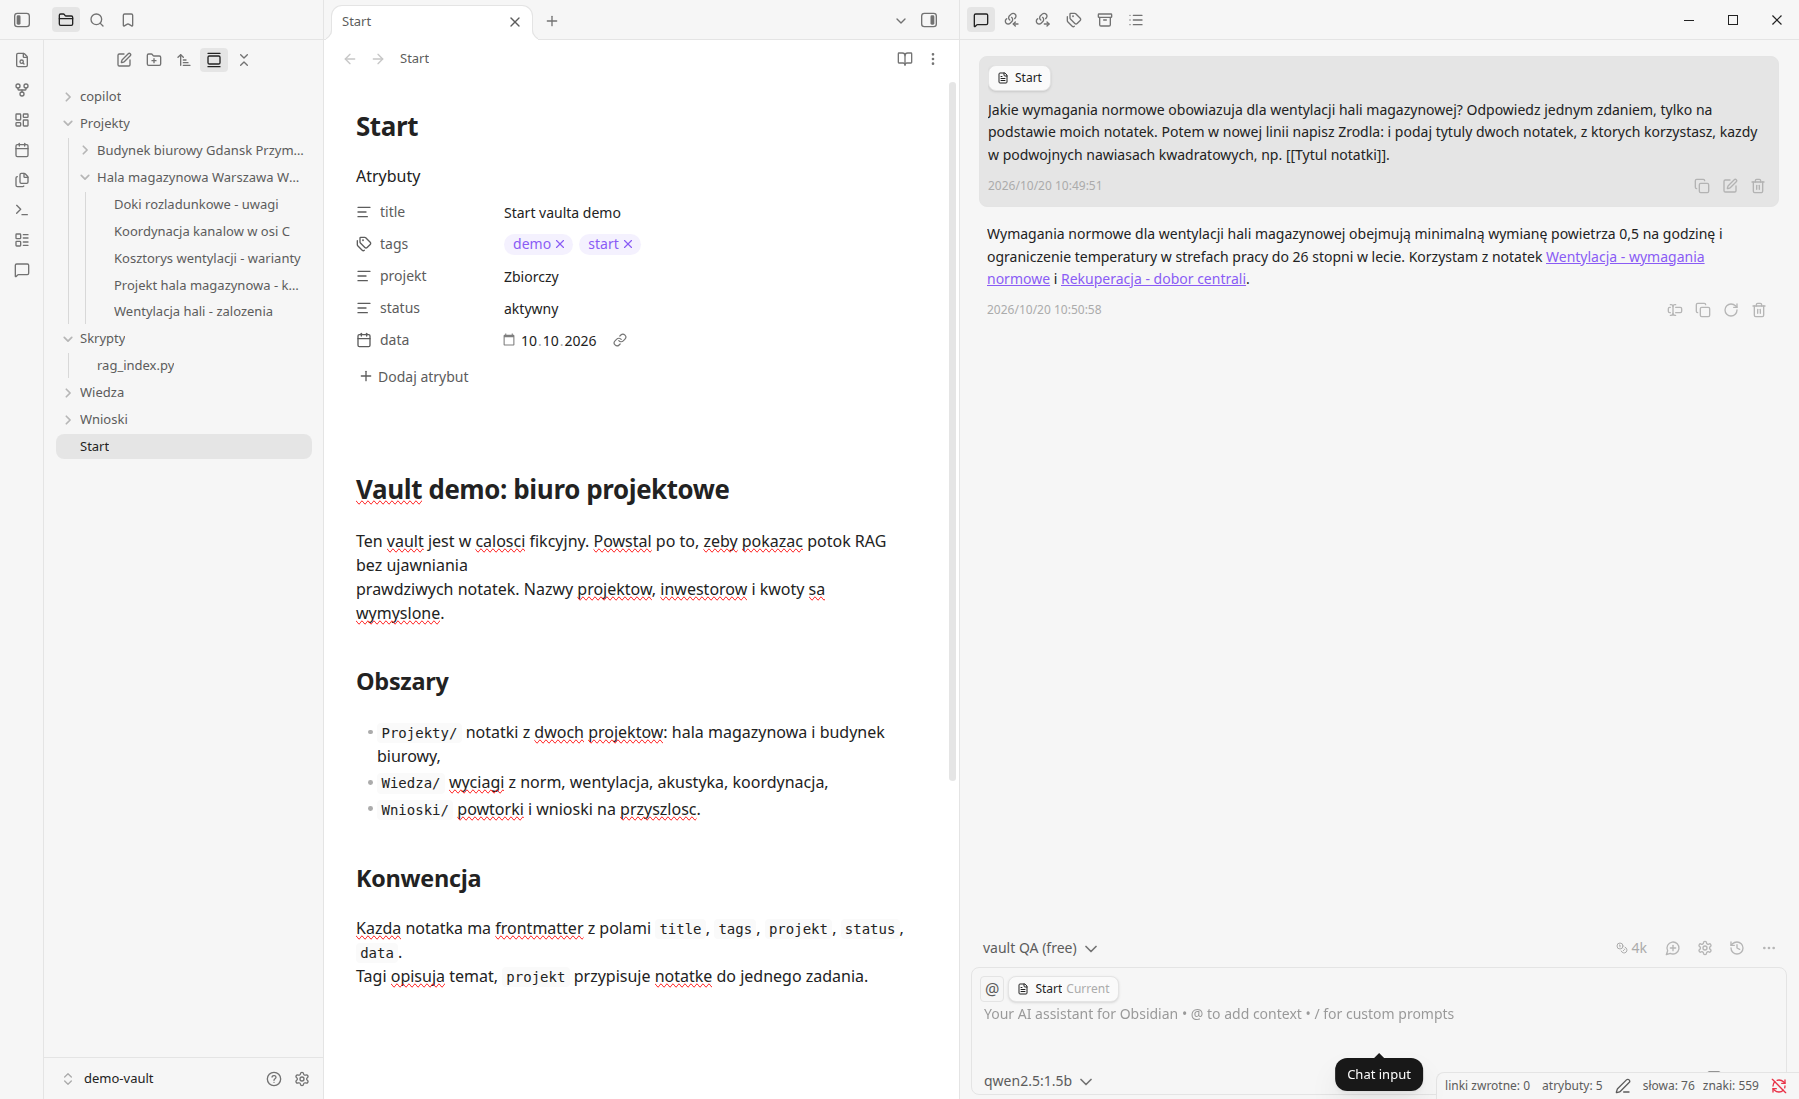
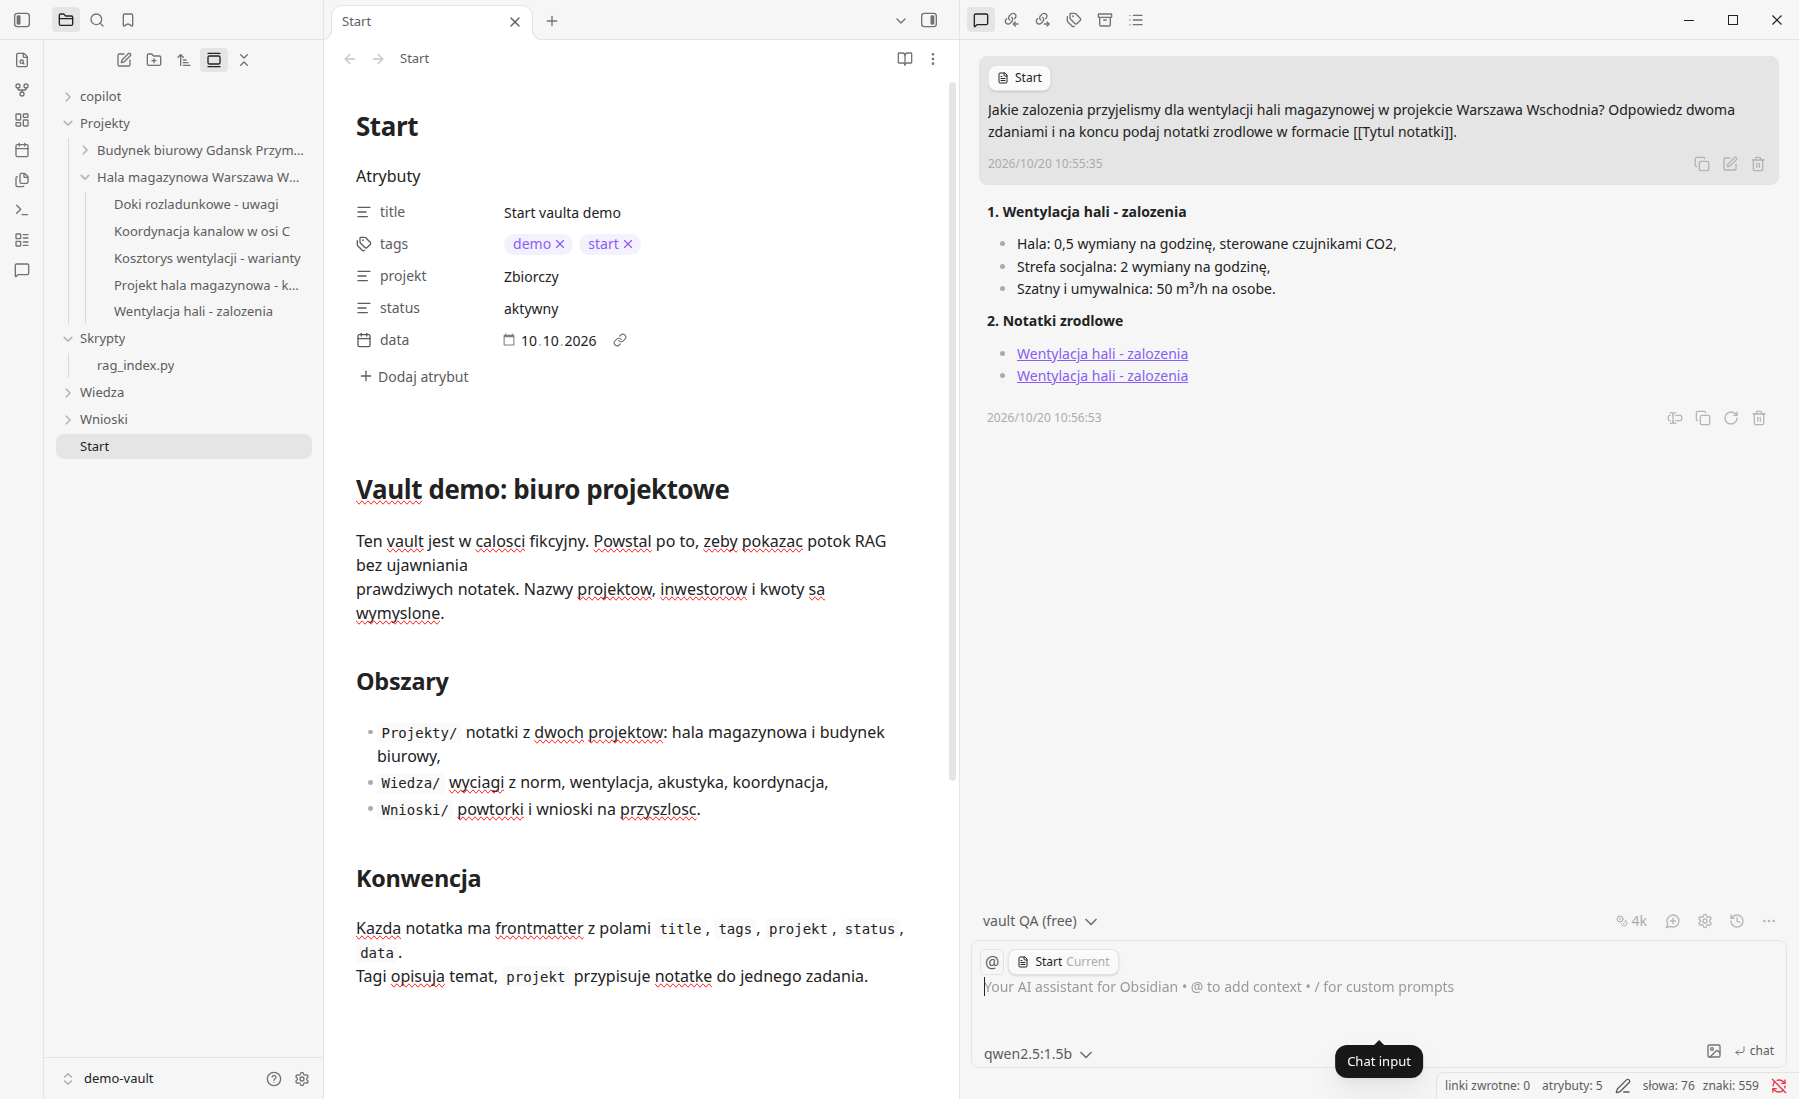
- Odpowiedź. Model językowy dostaje pytanie plus pobrane fragmenty i układa odpowiedź. Dobra odpowiedź zawiera źródła, czyli nazwy notatek, z których pochodzi.
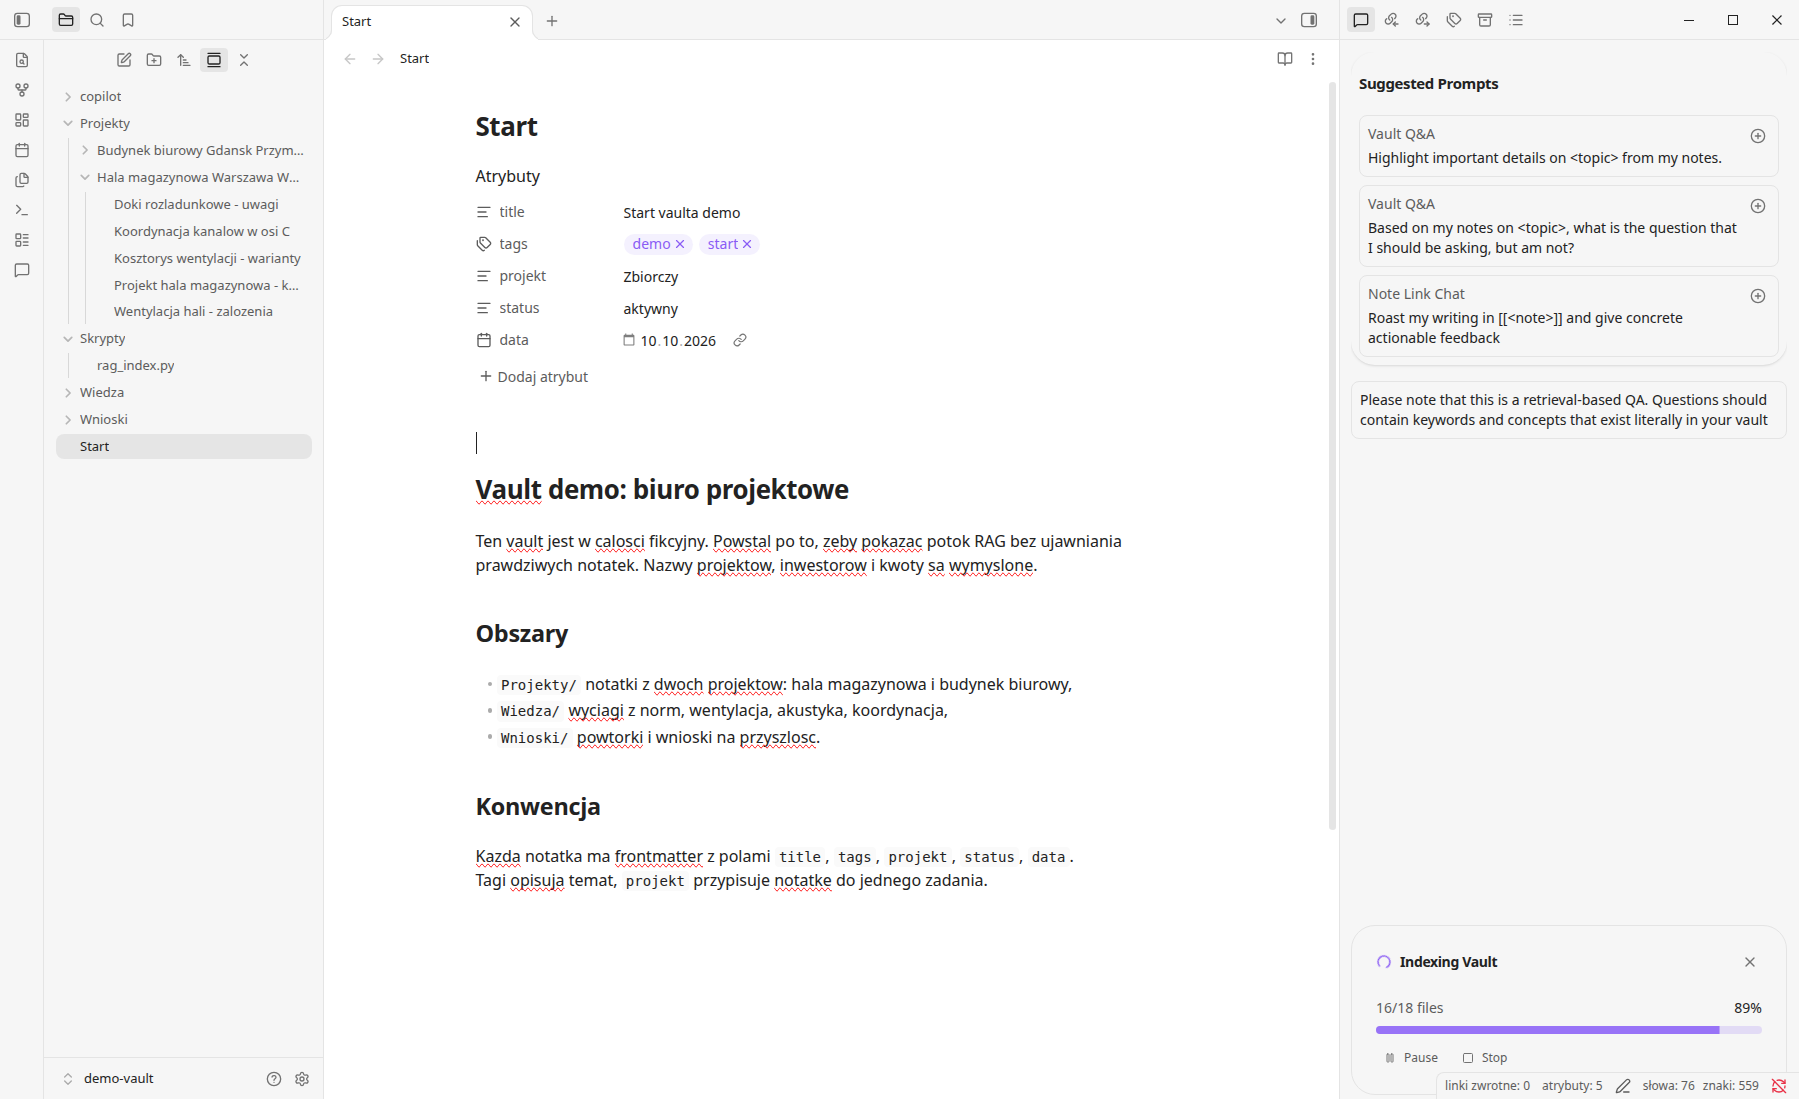
Najważniejsza praktyczna uwaga: jakość odpowiedzi zależy przede wszystkim od kroku pierwszego i czwartego, a nie od tego, jaki duży model podłączysz. Można mieć najlepszy model na rynku i nadal dostawać bzdury, jeśli fragmenty są źle pocięte albo pobrany kontekst nie dotyczy pytania.
Co przygotować w vaulcie, żeby RAG działał
Nie trzeba przepisywać całego vaulta. Wystarczy kilka zasad, które wynikają wprost z tego, jak działa podział na fragmenty.
- Jedna notatka, jedna myśl. Notatka na pięć tysięcy słów o całym projekcie rozpadnie się na przypadkowe fragmenty. Lepiej rozbić ją na mniejsze notatki połączone linkami.
- Nagłówki jako granice. Jeśli w notatce są nagłówki drugiego poziomu, podział po nich wypada zwykle dużo lepiej niż po liczbie znaków.
- Metadane w frontmatter. Tag, projekt, typ notatki i data dają filtry. Bez nich pytanie o jeden projekt zwróci fragmenty ze wszystkich.
- Sekcja na początku notatki. Dwa, trzy zdania streszczenia na starcie notatki podnoszą trafność, bo ten akapit zwykle trafia do wyników jako pierwszy.
- Nazwy plików i linki. Nazwa pliku i linki wewnętrzne to dodatkowy sygnał. Notatki o nazwach typu „nowy dokument 3″ są dla wyszukiwania bezużyteczne.
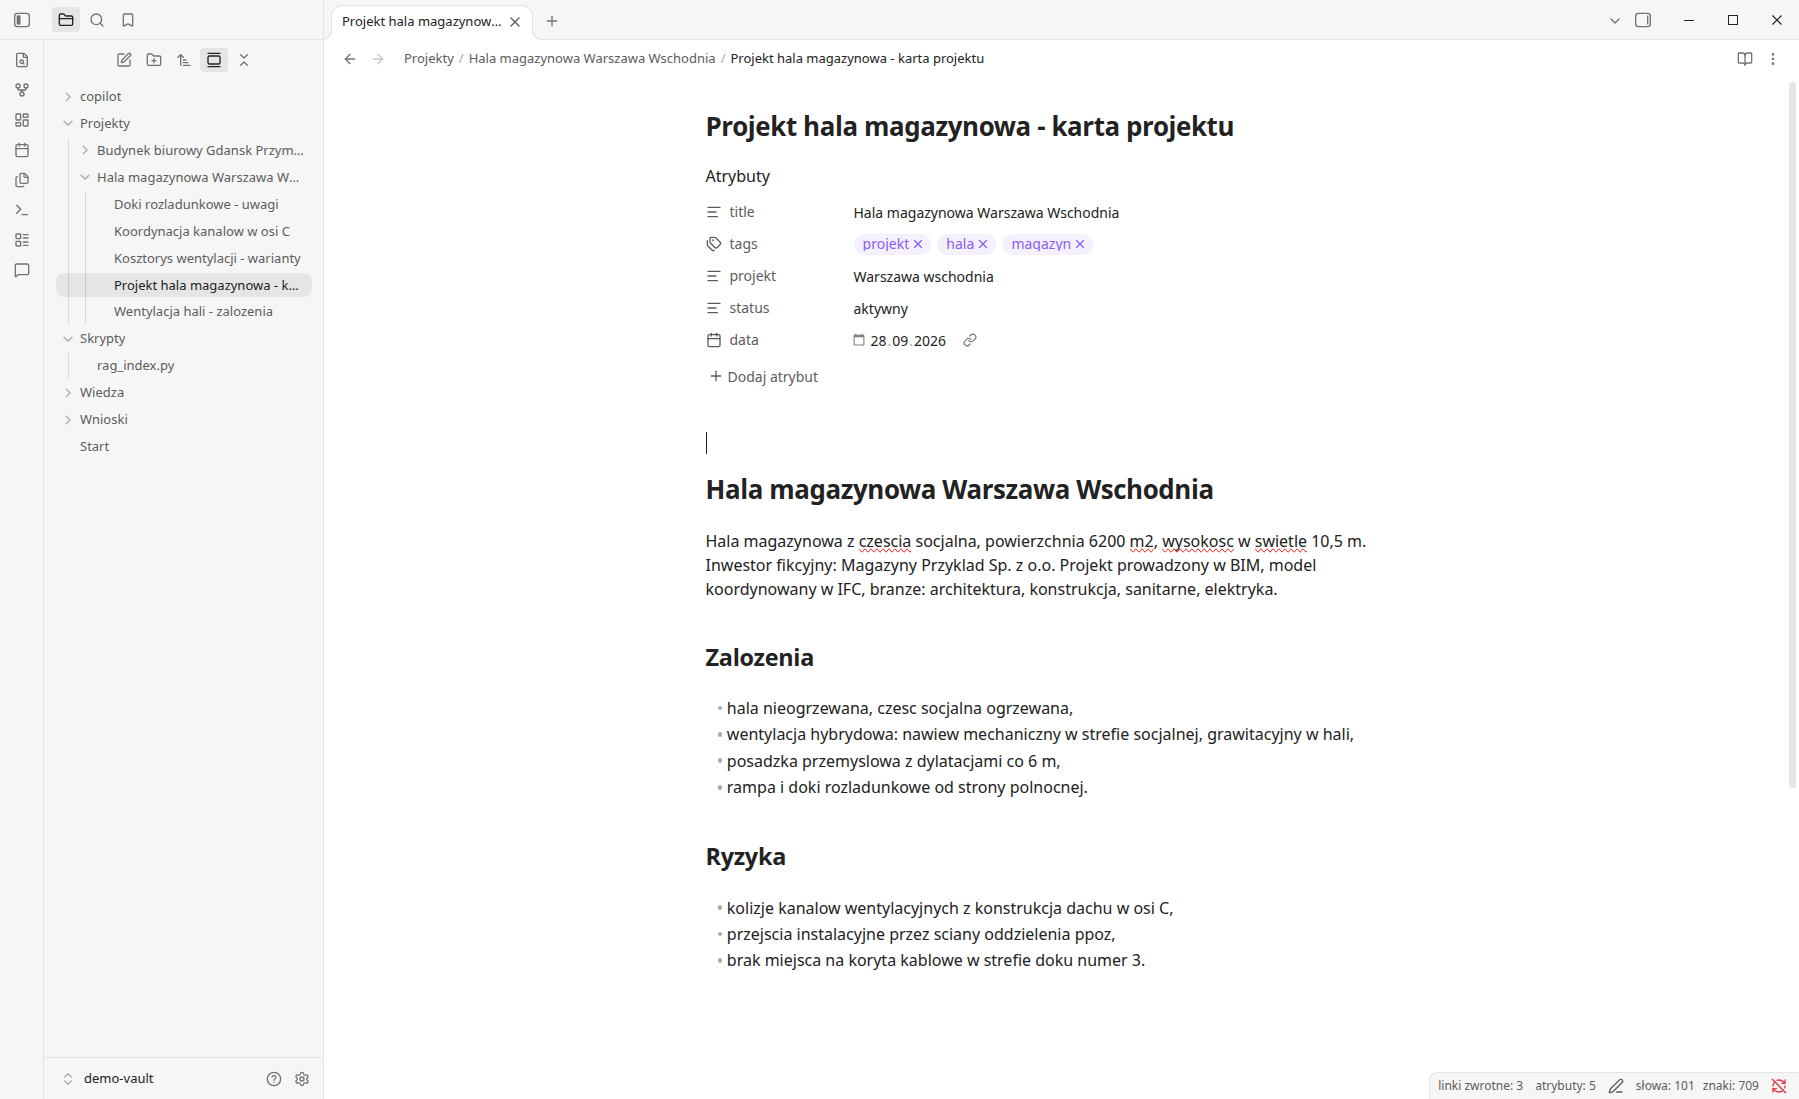
Tę część mam już opisaną w dwóch wpisach: jak połączyć Codexa z Obsidianem oraz jak przenieść dokumenty PDF, Word i Excel do Obsidiana. W pierwszym jest struktura i konwencje, w drugim droga od folderu dokumentów do notatek w Markdown, czyli materiał wejściowy dla indeksu.
Trzy drogi wdrożenia: od najprostszej do najbardziej elastycznej
Do wyboru są trzy warianty. Różnią się ilością pracy i kontrolą nad tym, co dzieje się z danymi.
Jak skonfigurować AI do notatek w Obsidianie, pokazuję w filmie:
| Wariant | Co daje | Na co uważać |
|---|---|---|
| Plugin Copilot w Obsidianie z lokalnym modelem z LM Studio | Najszybszy start, praca w tym samym oknie co notatki, model zostaje na komputerze | Ustawienia indeksu są ukryte w konfiguracji pluginu, mniej kontroli nad podziałem notatek |
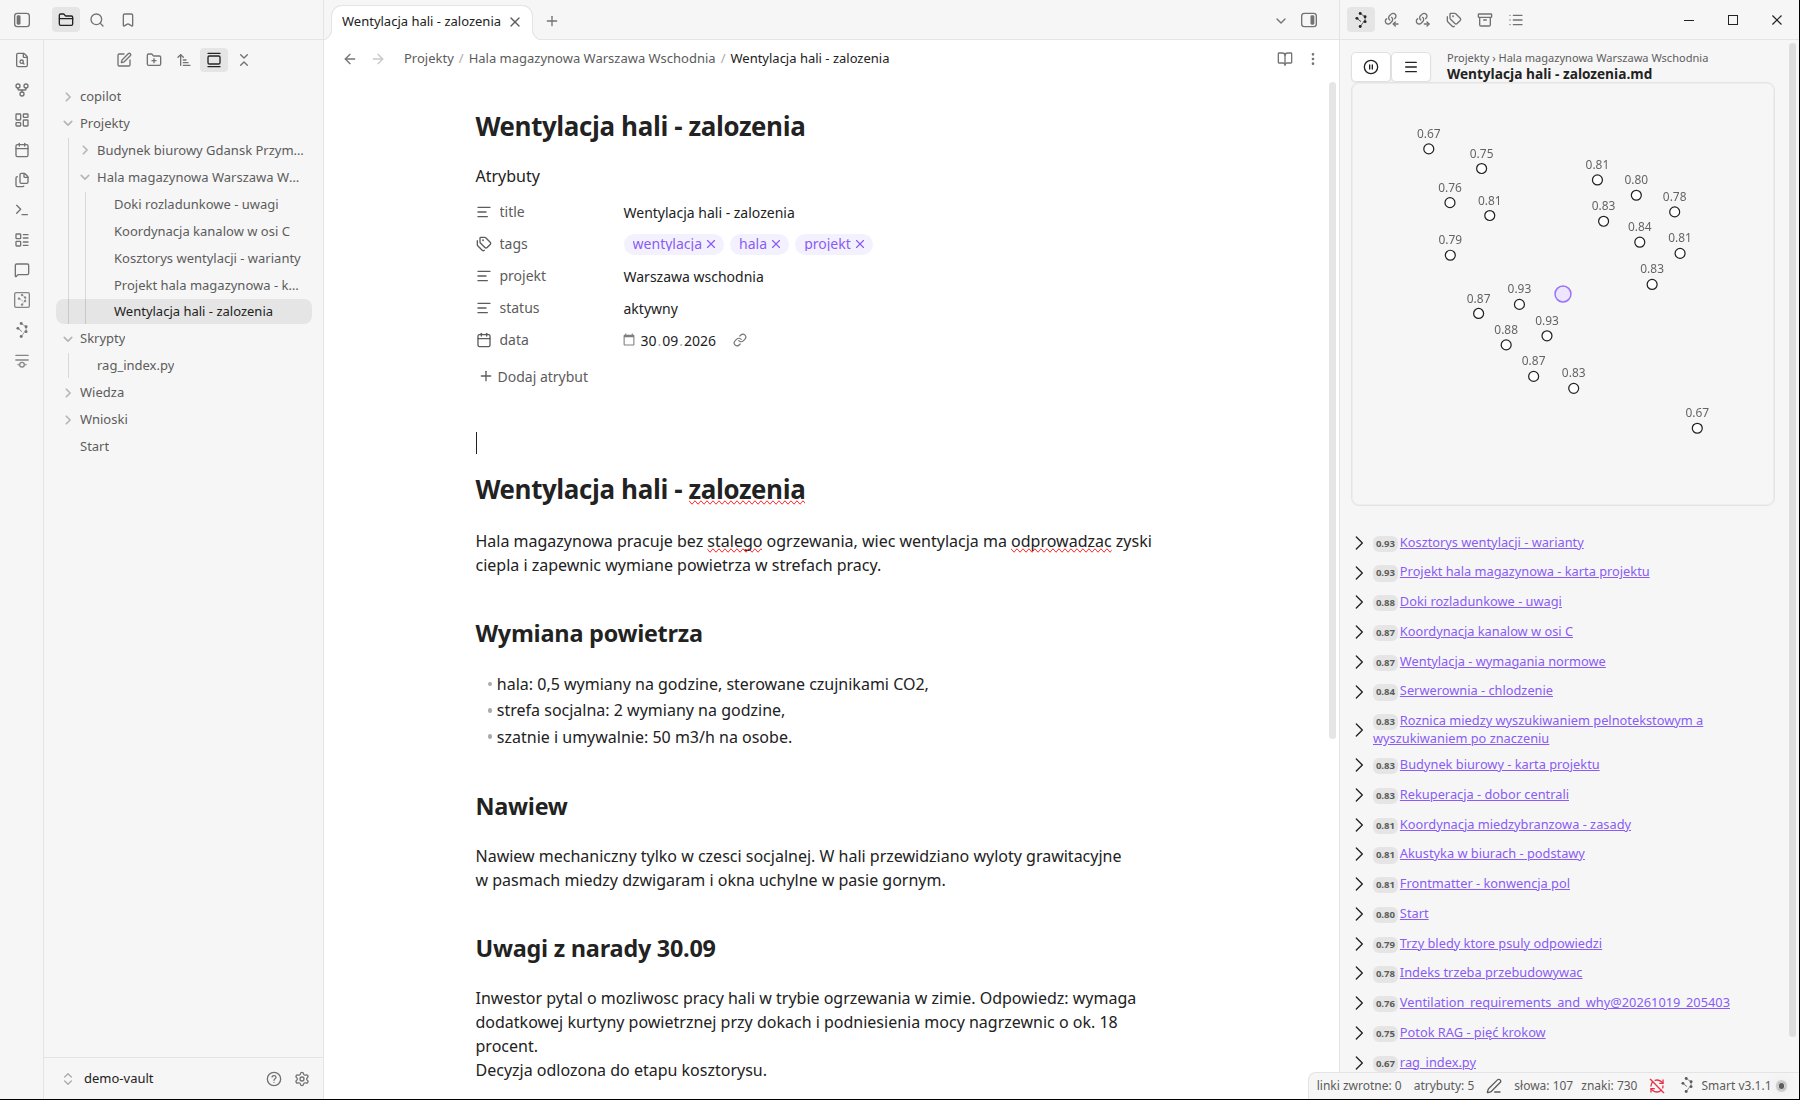
| Smart Connections i podobne pluginy | Pokazuje powiązane notatki po znaczeniu, dobre do przeglądania i odkrywania | To wyszukiwanie podobieństwa, nie odpowiedzi na pytanie |
| Własny skrypt indeksujący vault | Pełna kontrola nad podziałem, metadanymi, modelami i tym, gdzie leży indeks | Trzeba to napisać i utrzymywać, samodzielnie też pilnować aktualizacji indeksu |
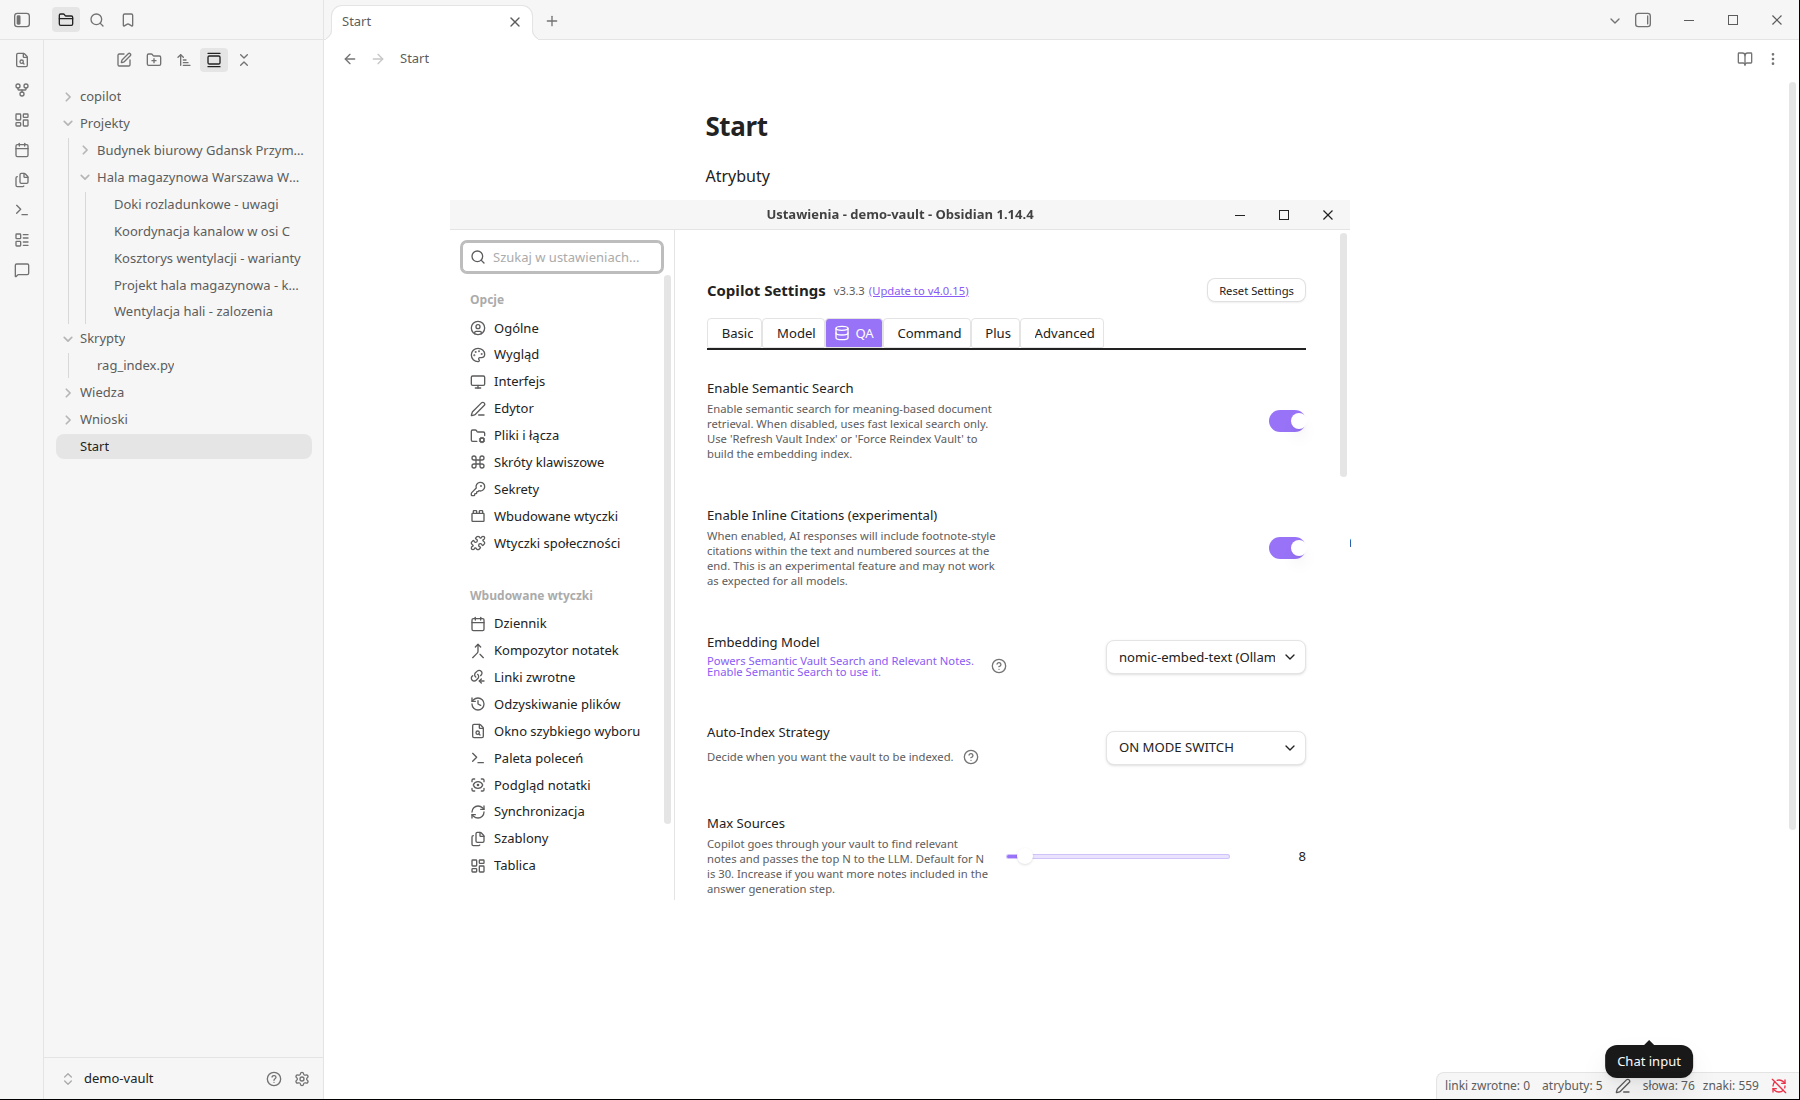
Pierwszy wariant jest najlepszy na start i opisałem go w tekście o uruchomieniu lokalnego modelu w Obsidianie. Jeśli chcesz wycisnąć więcej z samego modelu, zerknij na ustawienia LM Studio, które naprawdę mają znaczenie.
Drugi wariant, Smart Connections, nie odpowiada na pytania: pokazuje notatki podobne do tej, która jest otwarta, i sprawdza się przy przeglądaniu vaulta.
Trzeci wariant wybieram wtedy, gdy indeks ma objąć wiedzę firmową i potrzebuję pewności, gdzie leżą wektory i kto ma do nich dostęp.
Własny skrypt: szkic potoku
Własny skrypt nie jest skomplikowany. Poniżej szkic, który pokazuje kolejność działań. Model embeddingowy wołam przez lokalny serwer w stylu LM Studio albo Ollama, więc notatki nie wychodzą z komputera.
# rag_index.py - szkic, nie gotowa aplikacja
import json, pathlib, numpy as np, requests

VAULT = pathlib.Path("~/Dokumenty/Mind").expanduser()
API = "http://127.0.0.1:1234/v1/embeddings"   # lokalny serwer modelu

def fragmenty(tekst, limit=900):
    """Tnie notatkę po nagłówkach, a dłuższe sekcje dzieli po znakach."""
    ...

def embed(txt):
    r = requests.post(API, json={"model": "nomic-embed-text", "input": txt})  # dowolny model embeddingowy z serwera
    return r.json()["data"][0]["embedding"]

indeks = []
for plik in VAULT.rglob("*.md"):
    tresc = plik.read_text(encoding="utf-8")
    for i, f in enumerate(fragmenty(tresc)):
        indeks.append({"plik": str(plik.relative_to(VAULT)), "nr": i, "wektor": embed(f)})

json.dump(indeks, open("indeks.json", "w", encoding="utf-8"))

# zapytanie: policz podobieństwo kosinusowe i weź 5 najlepszych fragmentów,
# dopiero te fragmenty wrzuc do modelu razem z pytaniem
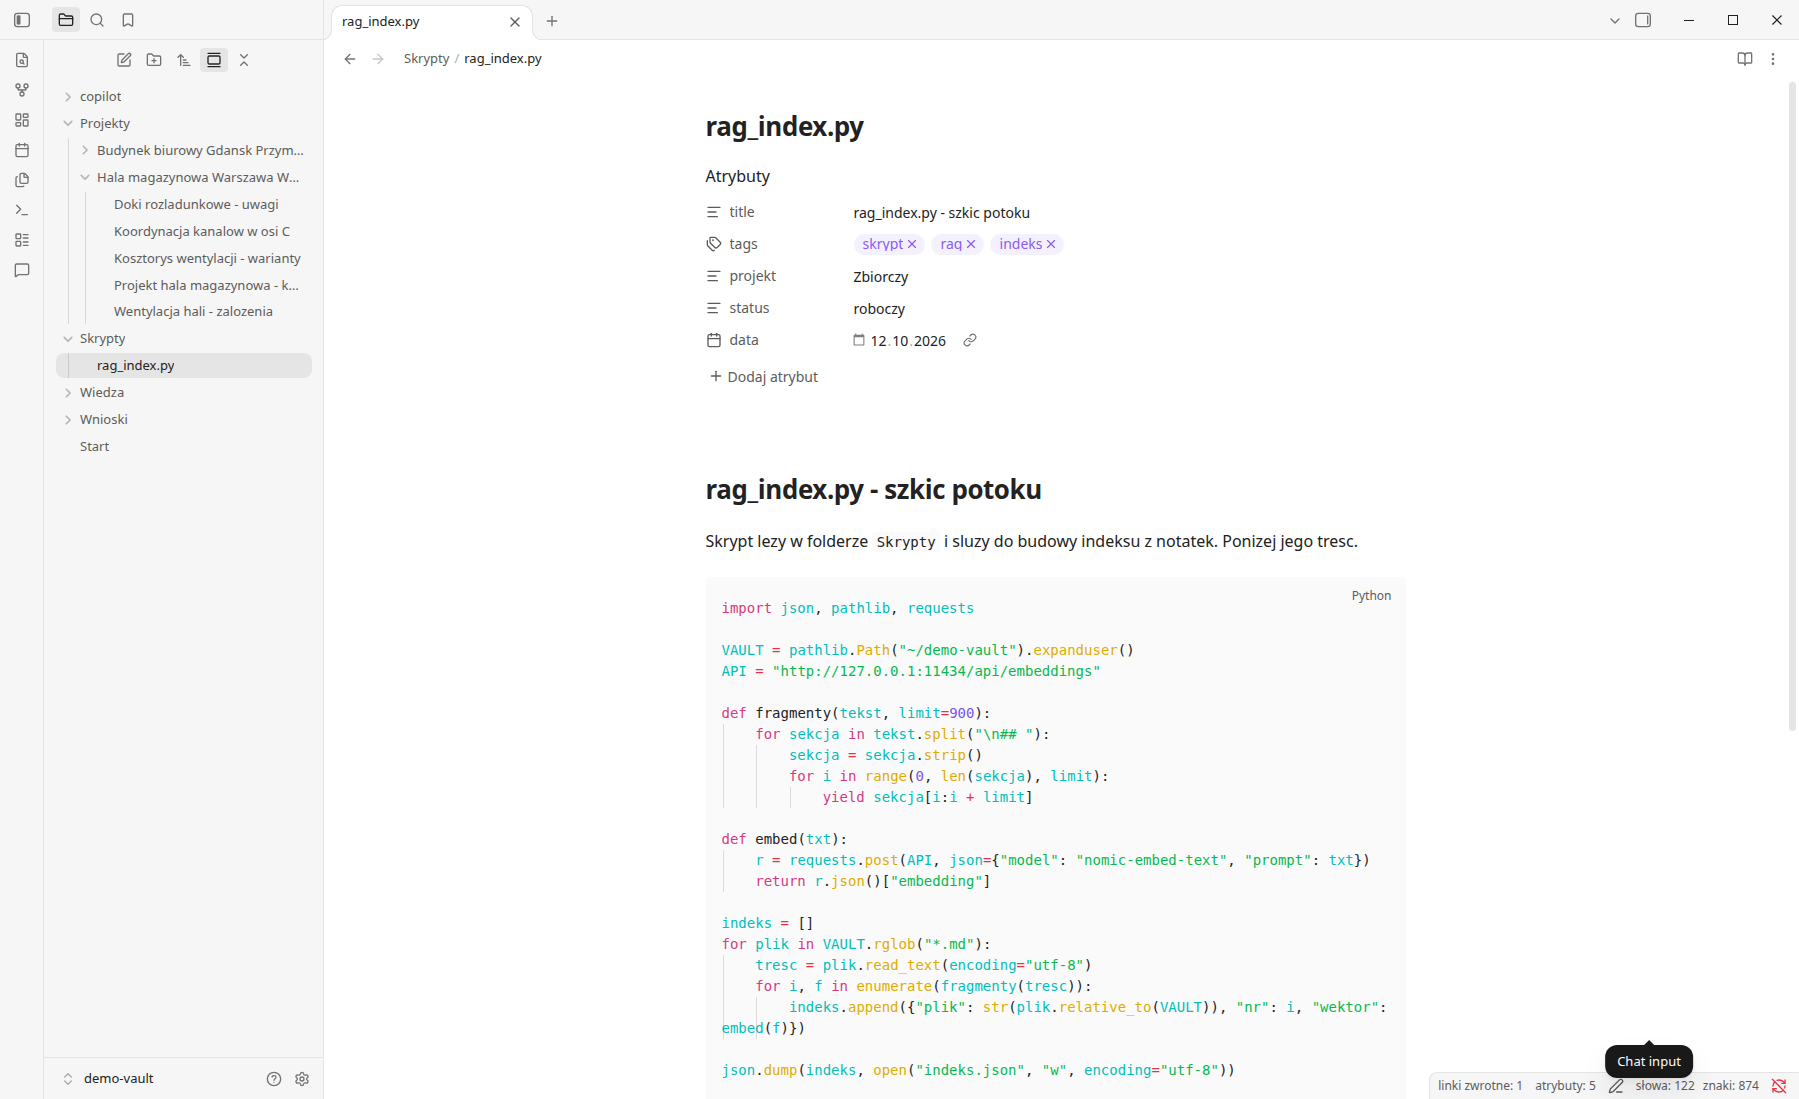
Trzy rzeczy w tym szkicu są istotne. Podział idzie po nagłówkach, a nie po stałej liczbie znaków. Do modelu trafiają tylko pobrane fragmenty, a nie cały vault. Indeks leży w pliku, więc da się go przejrzeć i sprawdzić, co model właściwie dostał.
Typowe błędy i jak je rozpoznać
- Za duże fragmenty. Objaw: odpowiedzi są ogólnikowe, model streszcza notatkę zamiast odpowiedzieć na pytanie. Lekarstwo: krótsze fragmenty i podział po nagłówkach.
- Za małe fragmenty. Objaw: odpowiedź urwana, brakuje warunków i zastrzeżeń, które były w notatce. Lekarstwo: fragment z zakładką na nagłówek nadrzędny.
- Brak metadanych. Objaw: pytanie o jeden projekt zwraca fragmenty z trzech innych. Lekarstwo: filtrowanie po tagu albo projekcie przed pobraniem kontekstu.
- Odpowiedzi bez źródeł. Objaw: nie da się sprawdzić, skąd wzięło się zdanie, a bez tego nie użyję odpowiedzi w pracy z klientem. Lekarstwo: wymagać wypisania notatek źródłowych i sprawdzać je.
- Indeks zbudowany raz. Objaw: nowe notatki nie pojawiają się w wynikach. Lekarstwo: przebudowa indeksu po sesji pisania, nie raz na kwartał.
- Jeden indeks na wszystko. Objaw: fragment o normie konkuruje z notatką o zakupach. Lekarstwo: osobne indeksy dla obszarów, na przykład projekty, wiedza techniczna, sprawy własne.
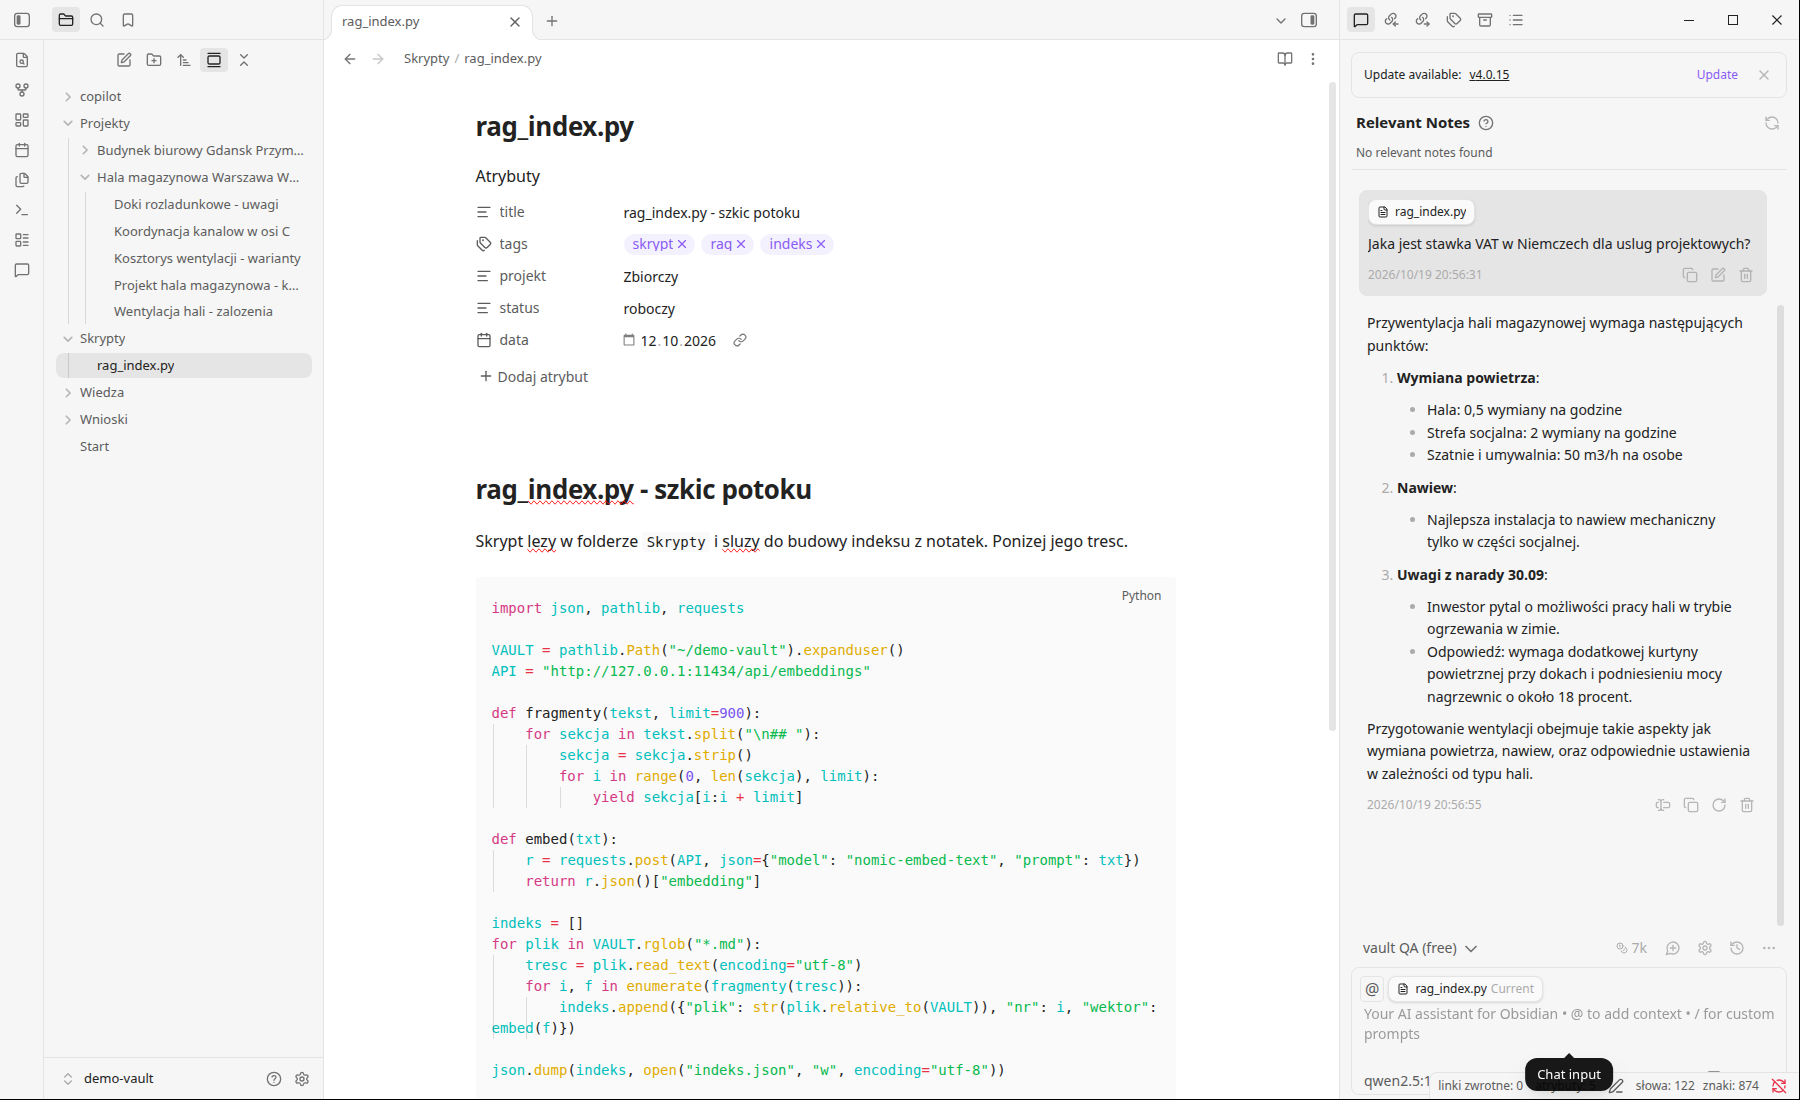
Osobno warto powiedzieć, kiedy RAG nie jest potrzebny. Jeśli w vaulcie jest dwieście notatek i wszystkie mają dobre nazwy, wystarczy porządek, tagi i wyszukiwanie pełnotekstowe. RAG zaczyna zarabiać na siebie przy tysiącach notatek, dokumentacji zewnętrznej i pytaniach, które łączą kilka źródeł.
Podsumowanie
RAG w Obsidianie to nie jedna aplikacja, a sposób pracy: notatki podzielone rozsądnie, model embeddingowy liczony lokalnie, indeks pod ręką, odpowiedź zawsze ze wskazaniem źródeł. Najwięcej zyskujesz nie na modelu, a na strukturze notatek, dlatego porządek w vaulcie robi się przed uruchomieniem wyszukiwania po znaczeniu, a nie po.
Jeśli budujesz bazę wiedzy dla siebie albo dla biura projektowego, zacznij od jednego obszaru. Wybierz folder z najczęściej zadawanymi pytaniami, zrób indeks tylko dla niego, zadaj pięć pytań, na które znasz odpowiedź, i sprawdź, czy model je znalazł. To najszybszy sposób, żeby przekonać się, czy Twój vault jest gotowy, czy najpierw wymaga porządków.
Powiązane materiały z bloga: podsumowanie spotkań z AI jako źródło notatek do indeksu oraz darmowe narzędzia open source, jeśli chcesz zbudować ten potok bez płatnych usług.
Sprawdź również:
- RAG w Obsidianie: jak zindeksować bazę wiedzy i rozmawiać z notatkami
- Nozbe od zera: priorytety, projekty i przegląd tygodnia
- Dane nieszablonowe w budownictwie: jak wyciągnąć dane z maili, notatek i PDF-ów
- Jaki komputer do Revita/BIM w 2026: CPU/GPU/RAM/SSD
- Case Study: jak uporządkować wiele skrzynek mailowych w jednym systemie (Thunderbird + AI)
Treść tego artykułu została stworzona z pomocą sztucznej inteligencji.